

Это Часть 3 руководства по миграции с PostgreSQL на ClickHouse. На практическом примере здесь показано, как моделировать данные в ClickHouse при миграции с PostgreSQL.Мы рекомендуем пользователям, переходящим с Postgres, прочитать руководство по моделированию данных в ClickHouse. В этом руководстве используется тот же набор данных Stack Overflow и рассматриваются несколько подходов с использованием возможностей ClickHouse. Пользователи, переходящие с OLTP-баз данных, часто ищут в ClickHouse аналогичное понятие. Увидев, что ClickHouse поддерживает синтаксис
PRIMARY KEY, они могут захотеть определять схему таблицы, используя те же ключи, что и в исходной OLTP-базе данных. Однако в данном случае это не подходит.
Чтобы понять, почему OLTP-первичный ключ не подходит для ClickHouse, нужно разобраться в основах индексирования ClickHouse. Для сравнения возьмем Postgres, но эти общие принципы применимы и к другим OLTP-базам данных.
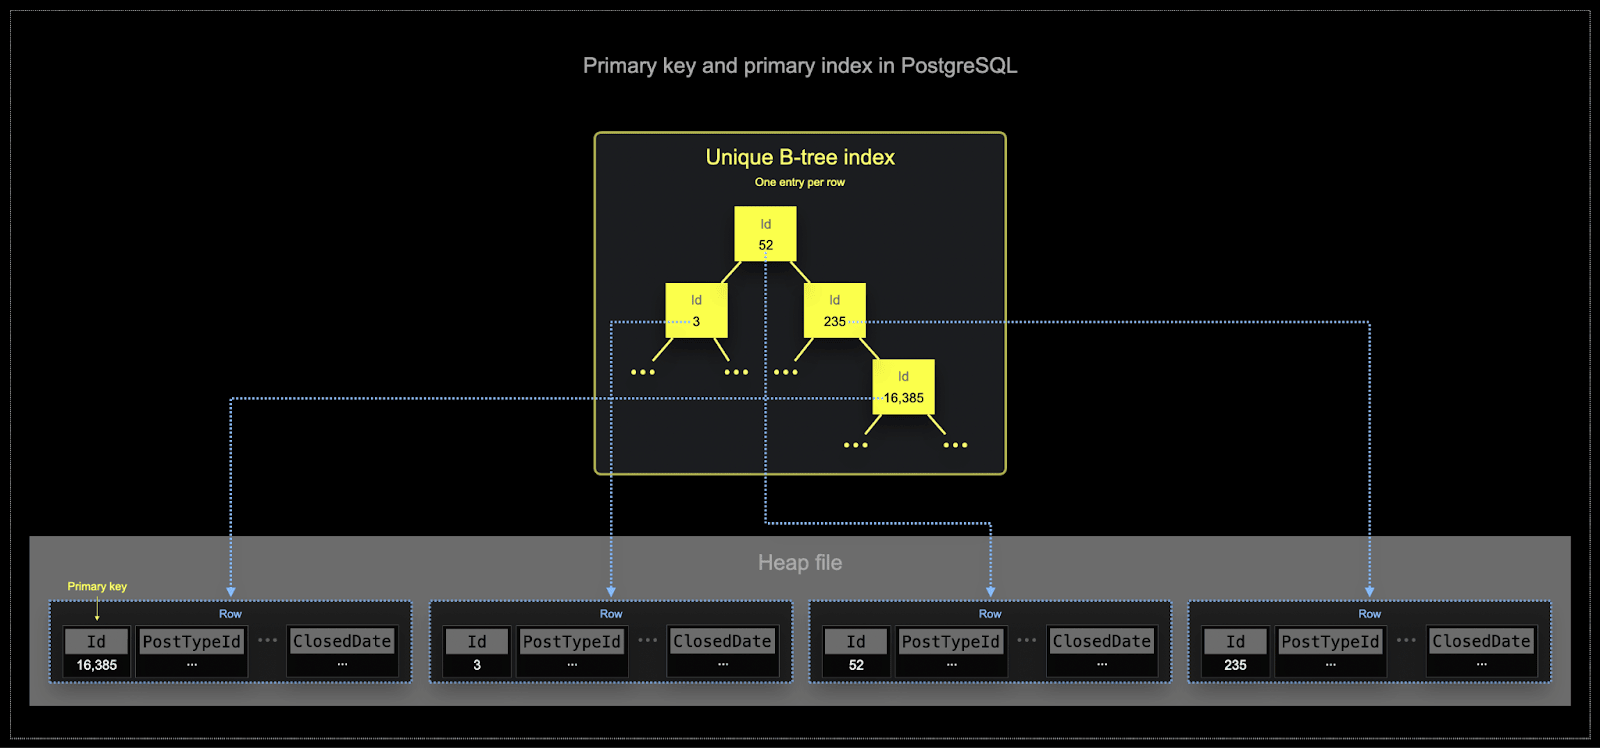
- Первичные ключи в Postgres по определению уникальны для каждой строки. Использование структур B-Tree позволяет эффективно находить отдельные строки по этому ключу. Хотя ClickHouse можно оптимизировать для поиска по значению в одной строке, аналитические рабочие нагрузки обычно требуют чтения нескольких столбцов сразу для большого числа строк. Чаще всего фильтрам нужно определить подмножество строк, по которому затем будет выполняться агрегация.
- Эффективное использование оперативной памяти и диска критически важно для тех масштабов, на которых обычно применяют ClickHouse. Данные записываются в таблицы ClickHouse фрагментами, называемыми частями, а затем к этим частям применяются правила фонового слияния. В ClickHouse у каждой части есть собственный первичный индекс. При слиянии частей первичные индексы слитой части тоже объединяются. В отличие от Postgres, эти индексы строятся не для каждой строки. Вместо этого первичный индекс части содержит одну запись индекса на группу строк — этот прием называется разреженным индексированием.
- Разреженное индексирование возможно потому, что ClickHouse хранит строки каждой части на диске в порядке, заданном указанным ключом. Вместо прямого поиска отдельных строк (как в индексе на основе B-Tree) разреженный первичный индекс позволяет быстро — с помощью двоичного поиска по записям индекса — определять группы строк, которые потенциально могут соответствовать запросу. Найденные группы потенциально подходящих строк затем параллельно передаются в движок ClickHouse для поиска совпадений. Такой подход позволяет сделать первичный индекс компактным (он целиком помещается в оперативную память) и при этом существенно ускорить выполнение запросов, особенно диапазонных — типичных для аналитики данных.
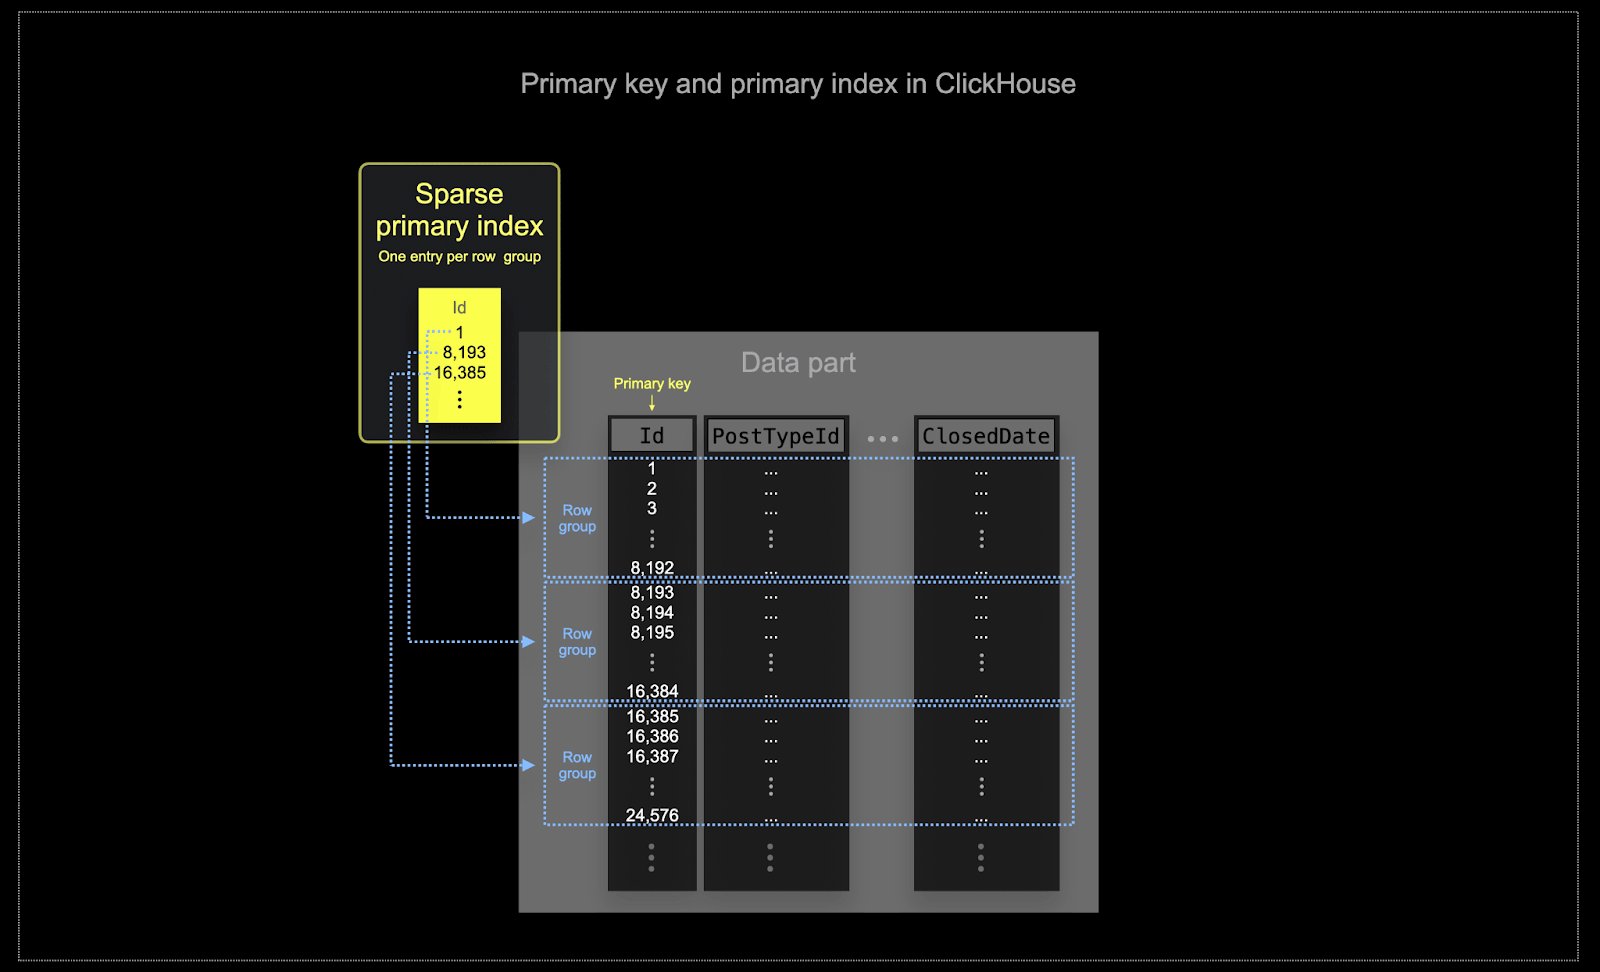
Все столбцы в таблице будут отсортированы по значению указанного ключа сортировки, независимо от того, входят ли они в сам ключ. Например, если в качестве ключа используетсяО том, что следует учитывать и какие шаги выполнить при выборе ключа сортировки, см. на примере таблицы Posts здесь. При использовании репликации в реальном времени с CDC нужно учитывать дополнительные ограничения; способы настройки ключей сортировки для CDC описаны в этой документации. Если вы работали с Postgres, вам, вероятно, знакома концепция партиционирования таблиц: для повышения производительности и упрощения управления большими базами данных таблицы делят на более мелкие и удобные части, называемые партициями. Такое партиционирование можно реализовать либо с помощью диапазона по указанному столбцу (например, по датам), либо с помощью заданных списков, либо с помощью хеша по ключу. Это позволяет администраторам организовывать данные по определенным критериям, таким как диапазоны дат или географическое расположение. Партиционирование помогает повысить производительность запросов, обеспечивая более быстрый доступ к данным за счет отсечения партиций и более эффективного индексирования. Оно также упрощает задачи обслуживания, такие как резервное копирование и удаление данных, позволяя выполнять операции над отдельными партициями, а не над всей таблицей. Кроме того, партиционирование может значительно повысить масштабируемость баз данных PostgreSQL, распределяя нагрузку между несколькими партициями. В ClickHouse партиционирование задается для таблицы при ее первоначальном определении с помощью предложенияCreationDate, порядок значений во всех остальных столбцах будет соответствовать порядку значений в столбцеCreationDate. Можно указать несколько ключей сортировки — в этом случае сортировка будет выполняться по тем же правилам, что и предложениеORDER BYв запросеSELECT.”
PARTITION BY. Это предложение может содержать SQL-выражение по любым столбцам, результат которого определяет, в какую партицию будет отправлена строка.
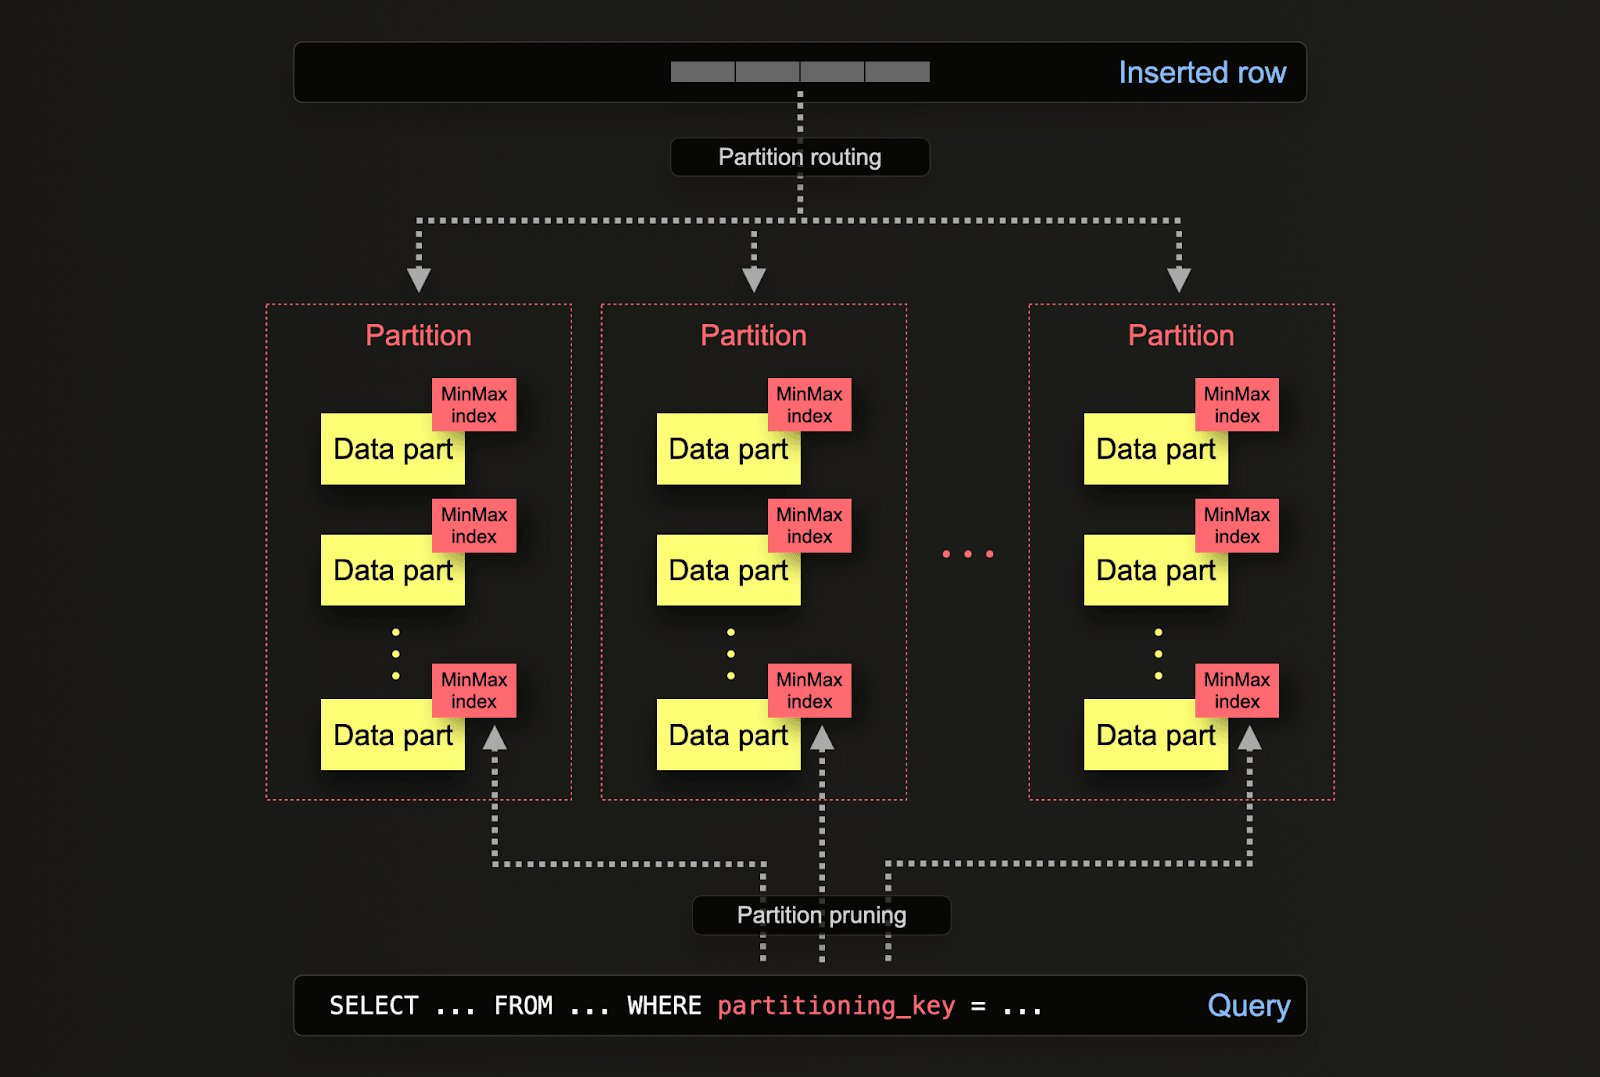
posts по годам с помощью выражения toYear(CreationDate). По мере вставки строк в ClickHouse это выражение будет вычисляться для каждой строки, и строка будет направляться в соответствующую партицию, если она уже существует (если строка для данного года первая, партиция будет создана).
- Управление данными - В ClickHouse партиционирование следует в первую очередь рассматривать как средство управления данными, а не как метод оптимизации запросов. При логическом разделении данных по ключу с каждой партицией можно работать независимо, например удалять её. Это позволяет эффективно перемещать партиции, а значит и подмножества данных, между уровнями хранения по времени, а также задавать срок хранения данных/эффективно удалять их из кластера. В примере ниже мы удаляем посты за 2008 год.
- Оптимизация запросов - Хотя партиции могут помочь повысить производительность запросов, это сильно зависит от характера доступа к данным. Если запросы затрагивают только несколько партиций (в идеале одну), производительность может улучшиться. Обычно это имеет смысл только тогда, когда ключ партиционирования не входит в первичный ключ и фильтрация выполняется по нему. Однако запросы, которым нужно охватывать много партиций, могут работать хуже, чем без партиционирования (поскольку из-за партиционирования может образовываться больше частей). Преимущество обращения к одной партиции будет еще менее заметным или вовсе отсутствовать, если ключ партиционирования уже находится среди первых полей первичного ключа. Партиционирование также можно использовать для оптимизации запросов GROUP BY, если значения в каждой партиции уникальны. Однако в целом следует убедиться, что первичный ключ оптимизирован, и рассматривать партиционирование как метод оптимизации запросов только в исключительных случаях, когда характер доступа предполагает работу с определенным предсказуемым подмножеством данных, например партиционирование по дням, если большинство запросов обращается только к последнему дню.
Внутри ClickHouse создаёт части для вставляемых данных. По мере вставки новых данных число частей увеличивается. Чтобы предотвратить чрезмерный рост числа частей, который ухудшает производительность запросов (из-за большего количества файлов для чтения), части объединяются в фоновом асинхронном процессе. Если число частей превышает заранее настроенный предел, ClickHouse сгенерирует исключение при вставке — ошибку “too many parts”. В нормальном режиме работы этого происходить не должно; такое случается только если ClickHouse настроен неправильно или используется некорректно, например при большом количестве мелких вставок.
Поскольку части создаются изолированно для каждой партиции, увеличение числа партиций приводит и к увеличению числа частей, то есть оно становится кратным числу партиций. Поэтому ключи партиционирования с высокой мощностью могут вызывать эту ошибку, и их следует избегать.Postgres позволяет создавать несколько индексов для одной таблицы, что дает возможность оптимизировать ее для различных сценариев доступа. Такая гибкость позволяет администраторам и разработчикам настраивать производительность базы данных под конкретные запросы и эксплуатационные потребности. Концепция проекций в ClickHouse, хотя и не является полным аналогом этого подхода, позволяет задавать для таблицы несколько секций
ORDER BY.
В документации по моделированию данных ClickHouse мы рассматриваем, как materialized view в ClickHouse можно использовать для предварительного вычисления агрегаций, преобразования строк и оптимизации запросов для различных сценариев доступа.
Во втором случае мы привели пример, где materialized view отправляет строки в целевую таблицу с другим ключом сортировки, чем у исходной таблицы, в которую выполняются вставки.
Например, рассмотрим следующий запрос:
UserId не является ключом сортировки.
Ранее мы решали эту задачу с помощью materialized view, выступающего в качестве механизма поиска для PostId. Ту же проблему можно решить
с помощью проекции. Приведённая ниже команда добавляет
проекцию для ORDER BY user_id.
ALTER, то после выполнения команды MATERIALIZE PROJECTION она создаётся асинхронно. Ход этой операции можно проверить с помощью следующего запроса, дождавшись значения is_done=1.
EXPLAIN мы также можем убедиться, что для этого запроса использовалась проекция:
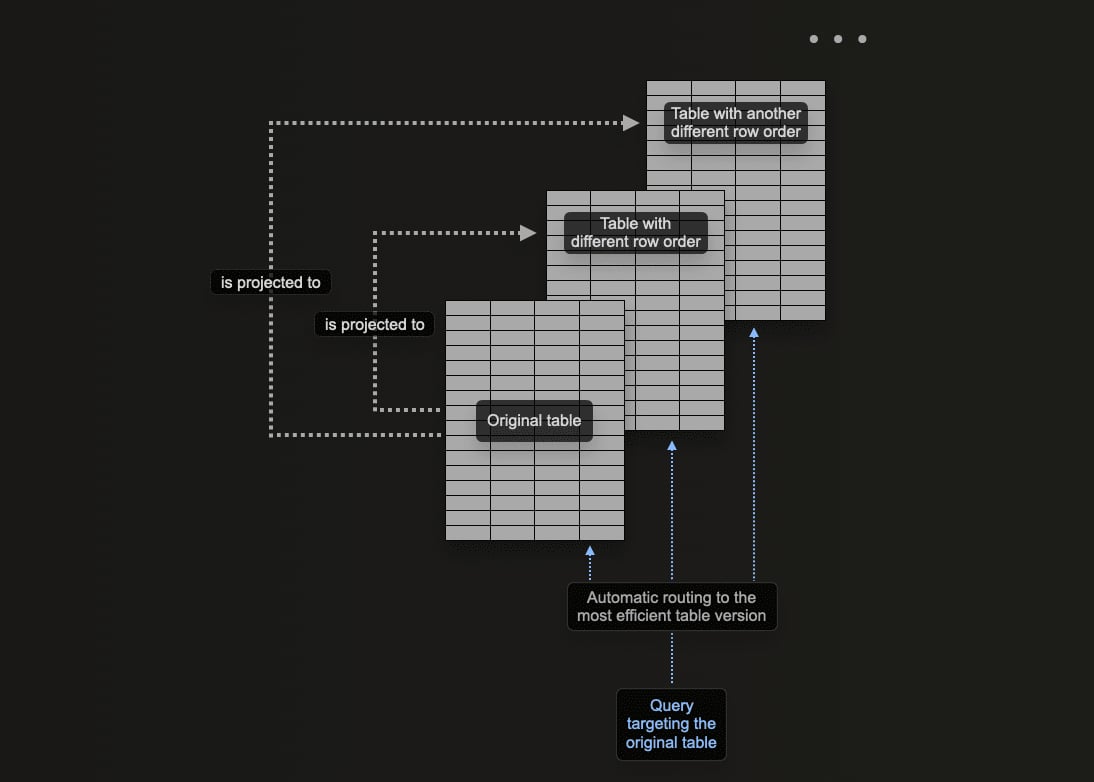
- Требуется полное переупорядочивание данных. Хотя выражение в
проекции теоретически может использовать
GROUP BY,materialized views эффективнее подходят для поддержки агрегатов. Оптимизатор запросов также с большей вероятностью будет использовать проекции с простым переупорядочиванием, то естьSELECT * ORDER BY x. В этом выражении можно выбрать подмножество столбцов, чтобы уменьшить объем хранилища. - Пользователи готовы к связанному с этим увеличению объема хранилища и дополнительным накладным расходам из-за двойной записи данных. Проверьте влияние на скорость вставки и оцените накладные расходы на хранение.
Начиная с версии 25.5, ClickHouse поддерживает виртуальный столбец
_part_offset в
проекциях. Это позволяет хранить проекции более экономно с точки зрения дискового пространства.Подробнее см. в разделе “Проекции”