

INSERT, UPDATE и DELETE. Хотя схожих результатов можно добиться и с помощью физической репликации, логическая репликация дает больше гибкости при выборе конкретных таблиц и операций, а также при преобразовании данных и поддержке разных версий Postgres.
В ClickHouse же сегменты и реплики — это два ключевых понятия, связанных с распределением данных и избыточностью. Реплики ClickHouse можно считать аналогом реплик Postgres, хотя репликация здесь не является строго синхронной и не предполагает основного узла. Сегментирование, в отличие от Postgres, поддерживается нативно.
Сегмент — это часть данных вашей таблицы. У вас всегда есть как минимум один сегмент. Сегментирование данных по нескольким серверам можно использовать для распределения нагрузки, если объем данных или вычислений превышает возможности одного сервера: в этом случае все сегменты используются для параллельного выполнения запроса. Вы можете вручную создавать сегменты для таблицы на разных серверах и вставлять данные непосредственно в них. В качестве альтернативы можно использовать distributed таблицу с ключом сегментирования, который определяет, в какой сегмент направляются данные. Ключ сегментирования может быть случайным или представлять собой результат работы хеш-функции. Важно, что сегмент может состоять из нескольких реплик.
Реплика — это копия ваших данных. В ClickHouse всегда есть как минимум одна копия ваших данных, поэтому минимальное число реплик равно одному. Добавление второй реплики ваших данных обеспечивает отказоустойчивость и потенциально дополнительные вычислительные ресурсы для обработки большего числа запросов (Parallel Replicas также можно использовать, чтобы распределить вычисления одного запроса и тем самым снизить задержку). Реплики реализуются с помощью движка таблицы ReplicatedMergeTree, который позволяет ClickHouse поддерживать синхронизацию нескольких копий данных на разных серверах. Репликация является физической: между узлами передаются только сжатые части, а не запросы.
Итак, реплика — это копия данных, которая обеспечивает избыточность и надежность (а также потенциально распределенную обработку), тогда как сегмент — это подмножество данных, которое позволяет реализовать распределенную обработку и балансировку нагрузки.
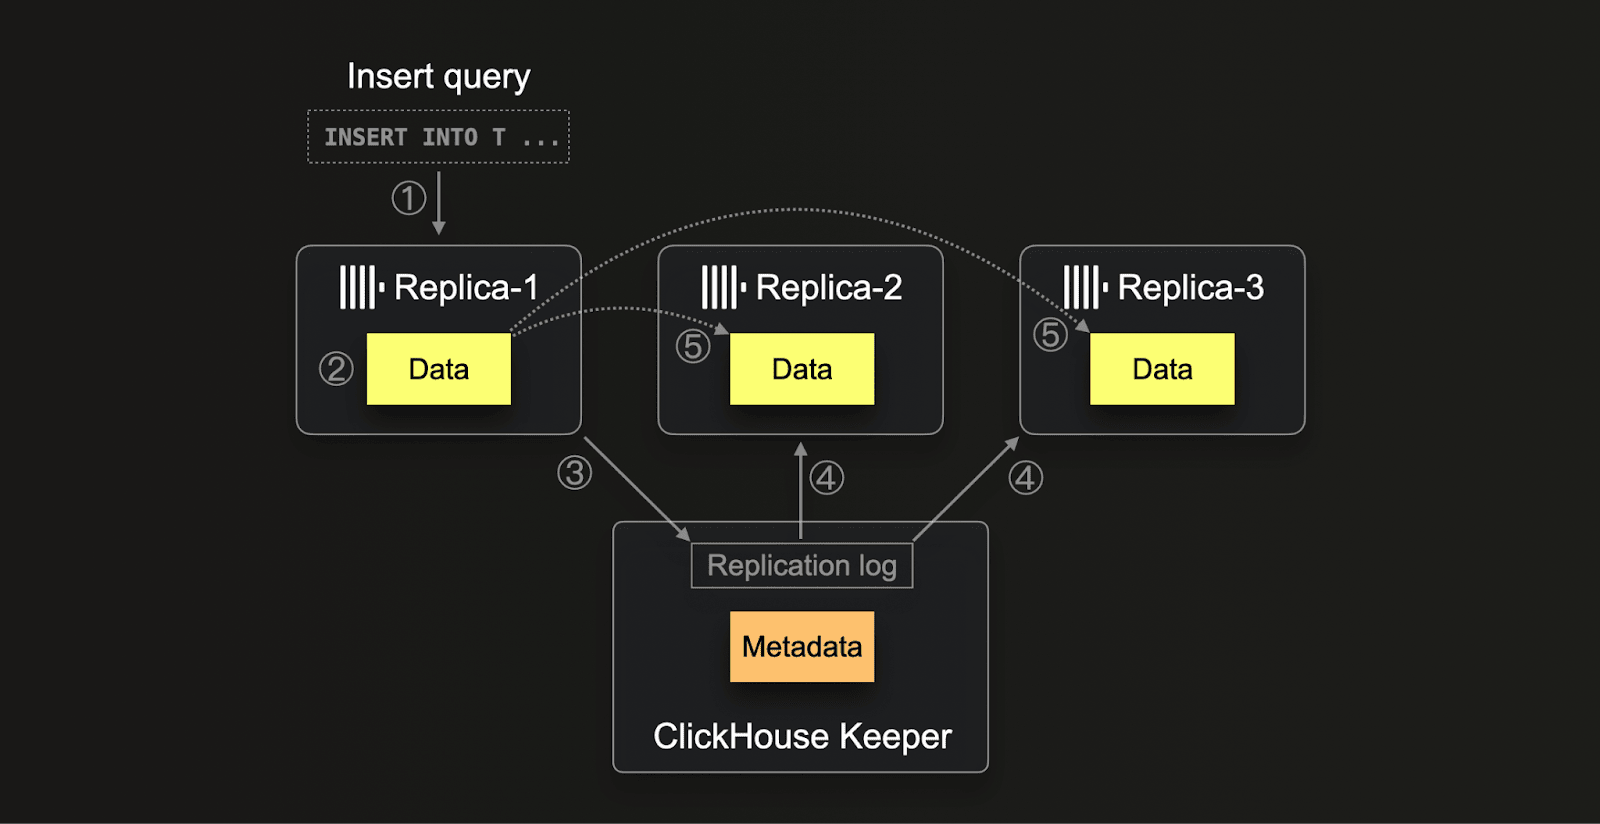
ClickHouse Cloud использует одну копию данных, хранящуюся в S3, и несколько вычислительных реплик. Данные доступны каждому узлу-реплике, и у каждого из них есть локальный кэш на SSD. Здесь используется только репликация метаданных через ClickHouse Keeper.ClickHouse использует ClickHouse Keeper (реализацию ZooKeeper на C++; также можно использовать ZooKeeper) для управления внутренним механизмом репликации, в основном для хранения метаданных и обеспечения согласованности в конечном счёте. Keeper используется для назначения уникальных последовательных номеров каждой вставке в распределённой среде. Это критически важно для поддержания порядка и согласованности операций. Этот механизм также обрабатывает фоновые операции, такие как слияния и мутации, распределяя эту работу и одновременно гарантируя, что она выполняется в одном и том же порядке на всех репликах. Помимо метаданных, Keeper выступает в роли полноценного центра управления репликацией: отслеживает контрольные суммы сохранённых частей данных и служит распределённой системой уведомлений между репликами. Процесс репликации в ClickHouse (1) начинается, когда данные вставляются в любую реплику. Эти данные в исходном виде (2) записываются на диск вместе с их контрольными суммами. После записи реплика (3) пытается зарегистрировать эту новую часть данных в Keeper, выделяя уникальный номер блока и записывая сведения о новой части. Другие реплики, (4) обнаружив новые записи в журнале репликации, (5) загружают соответствующую часть данных по внутреннему HTTP-протоколу, сверяя её с контрольными суммами, указанными в ZooKeeper. Такой подход гарантирует, что все реплики в конечном итоге будут содержать согласованные и актуальные данные, несмотря на различия в скорости обработки или возможные задержки. Кроме того, система способна выполнять несколько операций одновременно, что оптимизирует процессы управления данными, обеспечивает масштабируемость и повышает устойчивость к различиям в аппаратном обеспечении.
Обратитесь в службу поддержки, чтобы получить доступ к sticky endpoints.В OSS достижение такого поведения зависит от топологии ваших сегментов и реплик, а также от того, используете ли вы для выполнения запросов distributed таблицу. Если у вас только один сегмент и реплики (что встречается часто, поскольку ClickHouse обычно масштабируется вертикально), пользователи выбирают узел на уровне клиента и отправляют запрос напрямую в реплику, обеспечивая детерминированный выбор. Хотя топологии с несколькими сегментами и репликами возможны и без distributed таблицы, в таких продвинутых развертываниях обычно есть собственная инфраструктура маршрутизации. Поэтому мы исходим из того, что развертывания более чем с одним сегментом используют distributed таблицу (distributed таблицы можно использовать и в развертываниях с одним сегментом, но обычно в этом нет необходимости). В этом случае следует обеспечить согласованную маршрутизацию узлов на основе свойства, например
session_id или user_id. Настройки prefer_localhost_replica=0, load_balancing=in_order должны быть заданы в запросе. Это гарантирует, что предпочтение будет отдаваться локальным репликам сегментов, а в остальных случаях реплики будут выбираться в порядке, указанном в конфигурации, — при условии, что у них одинаковое число ошибок; если ошибок больше, произойдет переключение с случайным выбором. В качестве альтернативы для такого детерминированного выбора сегмента также можно использовать load_balancing=nearest_hostname.
При создании distributed таблицы вы укажете кластер. Это определение кластера, заданное в config.xml, будет содержать список сегментов (и их реплик), что позволит пользователям управлять порядком их использования с каждого узла. Так можно обеспечить детерминированный выбор.В редких случаях вам может потребоваться последовательная согласованность. Последовательная согласованность в базах данных означает, что операции над базой данных выглядят так, как будто они выполняются в некотором последовательном порядке, и этот порядок одинаков для всех процессов, взаимодействующих с базой данных. Это означает, что каждая операция как будто вступает в силу мгновенно — в промежутке между её вызовом и завершением, — и существует единый согласованный порядок, в котором все процессы наблюдают эти операции. С точки зрения пользователя это обычно означает необходимость записывать данные в ClickHouse и при чтении гарантированно получать последние вставленные строки. Этого можно добиться несколькими способами (в порядке предпочтения):
- Читать/писать в один и тот же узел - Если вы используете собственный протокол или сеанс для записи/чтения по HTTP, то должны быть подключены к одной и той же реплике: в этом случае вы читаете напрямую с того же узла, в который выполняете запись, поэтому чтение всегда будет согласованным.
- Синхронизировать реплики вручную - Если вы пишете в одну реплику, а читаете из другой, перед чтением можно выполнить
SYSTEM SYNC REPLICA LIGHTWEIGHT. - Включить последовательную согласованность - с помощью настройки запроса
select_sequential_consistency = 1. В OSS также необходимо указать настройкуinsert_quorum = 'auto'.
Подробнее о включении этих настроек см. здесь.
Использование последовательной согласованности создаёт дополнительную нагрузку на ClickHouse Keeper. В результате это может привести к замедлению вставок и чтения. SharedMergeTree, используемый в ClickHouse Cloud как основной движок таблицы, при последовательной согласованности создаёт меньше накладных расходов и лучше масштабируется. В OSS этот подход следует использовать с осторожностью и отслеживать нагрузку на Keeper.Пользователи, переходящие с PostgreSQL, как правило, привыкли к его надежной поддержке свойств ACID (атомарность, согласованность, изоляция, долговечность), что делает его надежным выбором для транзакционных баз данных. Атомарность в PostgreSQL означает, что каждая транзакция рассматривается как единое целое: она либо полностью выполняется, либо полностью откатывается, без частичных обновлений. Согласованность обеспечивается за счет ограничений, триггеров и правил, гарантирующих, что все транзакции переводят базу данных в корректное состояние. PostgreSQL поддерживает уровни изоляции от Read Committed до Serializable, что позволяет точно управлять видимостью изменений, внесенных параллельными транзакциями. Наконец, долговечность достигается с помощью упреждающего журналирования (WAL), что гарантирует: после фиксации транзакция сохраняется даже в случае сбоя системы. Эти свойства типичны для OLTP-баз данных, которые служат источником истины. При всей своей мощности такой подход имеет и врожденные ограничения, из-за которых сложно масштабироваться до объемов в PB. ClickHouse идет на компромисс в отношении этих свойств, чтобы обеспечивать быстрые аналитические запросы в большом масштабе при высокой пропускной способности записи. ClickHouse обеспечивает свойства ACID в ограниченных конфигурациях — проще всего при использовании нереплицируемого экземпляра движка таблицы MergeTree с одной партицией. Вне этих случаев рассчитывать на такие свойства не стоит, поэтому важно заранее убедиться, что они не являются обязательным требованием. Благодаря столбцово-ориентированному хранению в ClickHouse сжатие часто оказывается значительно эффективнее, чем в Postgres. Это наглядно видно при сравнении требований к хранилищу для всех таблиц Stack Overflow в обеих базах данных:
Query (Postgres)
Query (ClickHouse)
Response