

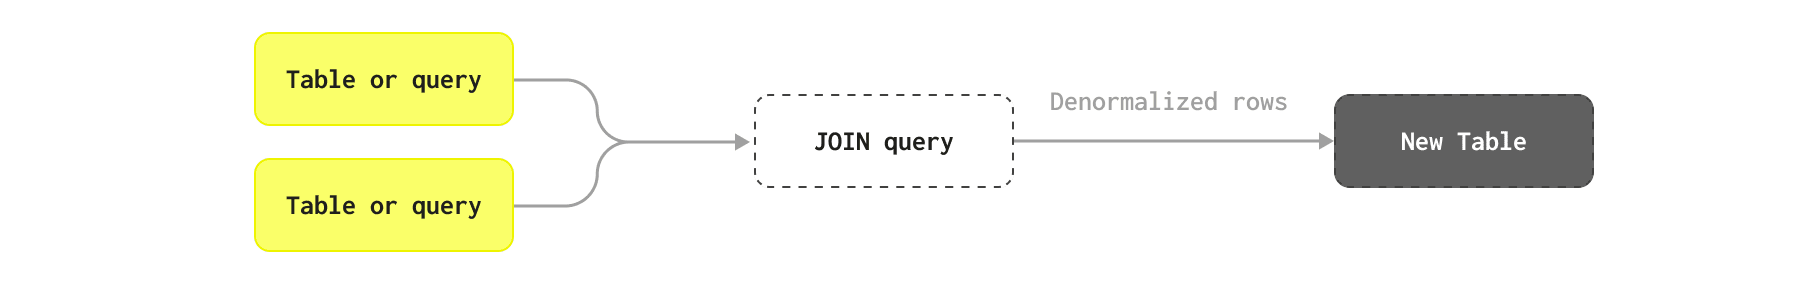
Распространённый приём, ставший популярным благодаря NoSQL-решениям, — денормализовать данные при отсутствии поддержки
JOIN, фактически сохраняя всю статистику или связанные строки в родительской строке в виде столбцов и вложенных объектов. Например, в типовой схеме блога можно хранить все Comments как Array объектов в соответствующих постах.
В целом мы рекомендуем денормализовывать данные в следующих случаях:
- Денормализуйте таблицы, которые меняются редко, или таблицы, для которых допустима задержка перед тем, как данные станут доступны для аналитических запросов, то есть когда данные можно полностью перезагрузить батчем.
- Избегайте денормализации связей многие-ко-многим. Это может привести к необходимости обновлять множество строк при изменении одной исходной строки.
- Избегайте денормализации связей с высокой мощностью. Если каждая строка в таблице имеет тысячи связанных записей в другой таблице, их потребуется представлять в виде
Array— либо примитивного типа, либо кортежей. Как правило, массивы с более чем 1000 кортежей не рекомендуются. - Вместо денормализации всех столбцов в виде вложенных объектов рассмотрите возможность денормализовать только статистику с помощью materialized views (см. ниже).
- Необходимо запускать корректные операторы JOIN при изменении строки таблицы. В идеале это не должно приводить к обновлению всех объектов, участвующих в JOIN, — только тех, которых затронуло изменение. Изменить JOIN так, чтобы они эффективно отфильтровывали нужные строки, и обеспечить это при высокой пропускной способности без внешних инструментов или дополнительных инженерных усилий сложно.
- Обновления строк в ClickHouse требуют аккуратного управления, что добавляет дополнительную сложность.
Поэтому на практике чаще используется процесс батч-обновления, при котором все денормализованные объекты периодически перезагружаются. Рассмотрим несколько практических примеров, в которых денормализация может быть оправданна, а также случаи, где предпочтительнее альтернативные подходы. Возьмем таблицу
Posts, которая уже денормализована и содержит такие статистические поля, как AnswerCount и CommentCount — исходные данные представлены именно в таком виде. На практике эту информацию, возможно, стоило бы, наоборот, нормализовать, поскольку она, скорее всего, будет часто меняться. Многие из этих столбцов также доступны через другие таблицы; например, комментарии к посту можно получить через столбец PostId и таблицу Comments. Для целей этого примера будем считать, что посты перезагружаются в рамках батч-процесса.
Мы также рассматриваем только денормализацию других таблиц в Posts, поскольку считаем ее основной таблицей для аналитики. Денормализация в обратном направлении также может быть уместна для некоторых запросов — с учетом тех же соображений, что описаны выше.
В каждом из следующих примеров будем считать, что существует запрос, требующий использования обеих таблиц в JOIN.
Голоса, относящиеся к постам, представлены в отдельных таблицах. Ниже показаны оптимизированная схема и команда вставки для загрузки данных:
Score представляет собой такую статистику, то есть общее число положительных голосов минус число отрицательных. В идеале эту статистику можно было бы получать во время выполнения запроса с помощью простого поиска по ключу (см. словари).
Теперь рассмотрим наши Users и Badges:
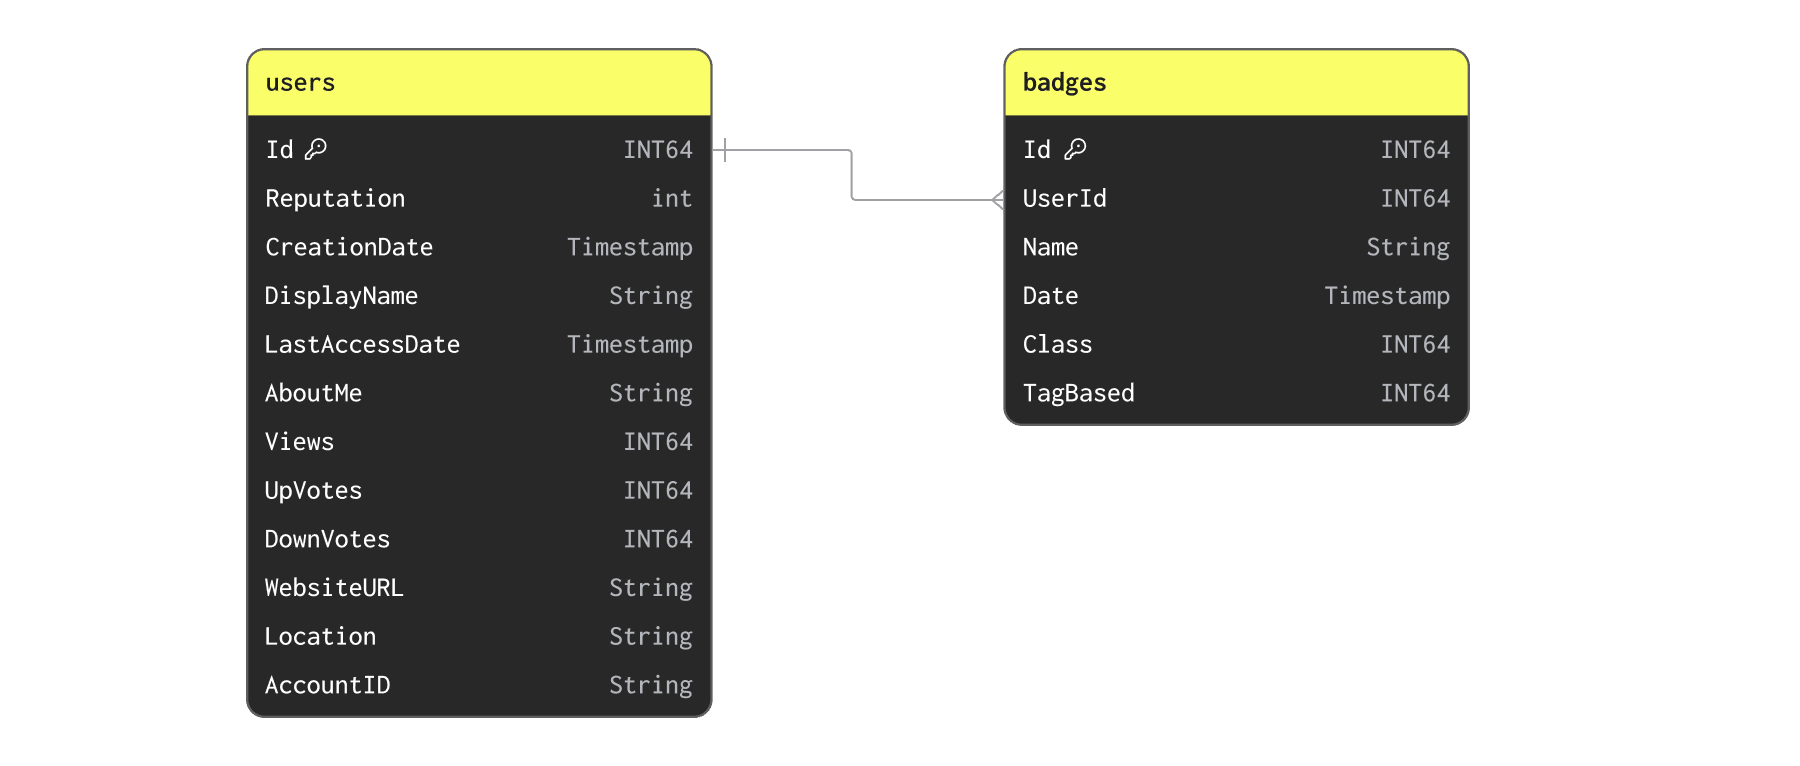
Возможно, имеет смысл денормализовать статистику из Badges в Users, например число значков. Такой пример мы рассмотрим при использовании словарей для этого набора данных при вставке.
PostLinks связывают Posts, которые пользователи считают связанными или дублирующими друг друга. Следующий запрос показывает схему и команду загрузки:
INSERT INTO SELECT, объединяя с помощью JOIN статистику дубликатов и посты.
- Именованные Tuple — позволяют представить связанную структуру в виде набора столбцов.
- Array(Tuple) или Nested — массив именованных Tuple, также известный как Nested, где каждый элемент представляет объект. Применимо к связям «один-ко-многим».
PostLinks в Posts.
Каждый пост может содержать несколько ссылок на другие посты, как ранее было показано в схеме PostLinks. При использовании типа Nested эти связанные и дублирующиеся посты можно представить следующим образом:
Обратите внимание на параметр flatten_nested=0. Мы рекомендуем отключить разворачивание вложенных данных.
Эту денормализацию можно выполнить с помощью запроса INSERT INTO SELECT с OUTER JOIN:
Обратите внимание, сколько времени это заняло. Нам удалось денормализовать 66 млн строк примерно за 2 минуты. Как мы увидим позже, эту операцию можно выполнять по расписанию.Обратите внимание на использование функций
groupArray: перед JOIN они сворачивают PostLinks в массив для каждого PostId. Затем этот массив фильтруется в два подсписка — LinkedPosts и DuplicatePosts; при этом также исключаются все пустые результаты внешнего JOIN.
Мы можем выбрать несколько строк, чтобы увидеть нашу новую денормализованную структуру:
INSERT INTO SELECT. Это подходит для периодически выполняемых батч-преобразований.
У пользователей есть несколько вариантов оркестрации этого процесса в ClickHouse, если допустим периодический процесс батч-загрузки:
- Refreshable Materialized Views - Refreshable materialized views можно использовать для периодического запуска запроса по расписанию с записью результатов в целевую таблицу. При выполнении запроса представление обеспечивает атомарное обновление целевой таблицы. Это даёт встроенный в ClickHouse механизм планирования такой работы.
- Внешние инструменты - Использование таких инструментов, как dbt и Airflow, для периодического запуска преобразования. Интеграция ClickHouse для dbt гарантирует, что это выполняется атомарно: создаётся новая версия целевой таблицы, а затем она атомарно обменивается с версией, обслуживающей запросы (через команду EXCHANGE).