

-
- Если на узле, принимающем данные, возникают проблемы, запрос на вставку завершится по тайм-ауту (или вернет более конкретную ошибку), и подтверждение получено не будет.
-
- Если узел записал данные, но из-за сетевых сбоев не может вернуть подтверждение отправителю запроса, отправитель либо получит тайм-аут, либо ошибку сети.
internal_replication=true.
Это позволит ClickHouse реплицировать данные на любые доступные реплики сегментов и обеспечит итоговую согласованность данных.
Если такая балансировка нагрузки на стороне клиента неудобна, то можно выполнять вставку через distributed таблицу, которая затем распределит записи по узлам. В этом случае также рекомендуется установить internal_replication=true.
Однако стоит отметить, что этот подход немного менее производителен, поскольку записи сначала выполняются локально на узле с distributed таблицей, а затем отправляются в сегменты.
Есть сценарии, в которых батчинг на стороне клиента нецелесообразен, например в задачах обсервабилити, где сотни или тысячи специализированных агентов отправляют журналы, метрики, трейсы и т. д.
В таких сценариях критически важна передача данных в реальном времени, чтобы как можно быстрее обнаруживать проблемы и аномалии.
Кроме того, в наблюдаемых системах возможны всплески событий, которые могут привести к резкому росту потребления памяти и связанным с этим проблемам при попытке буферизовать данные обсервабилити на стороне клиента.
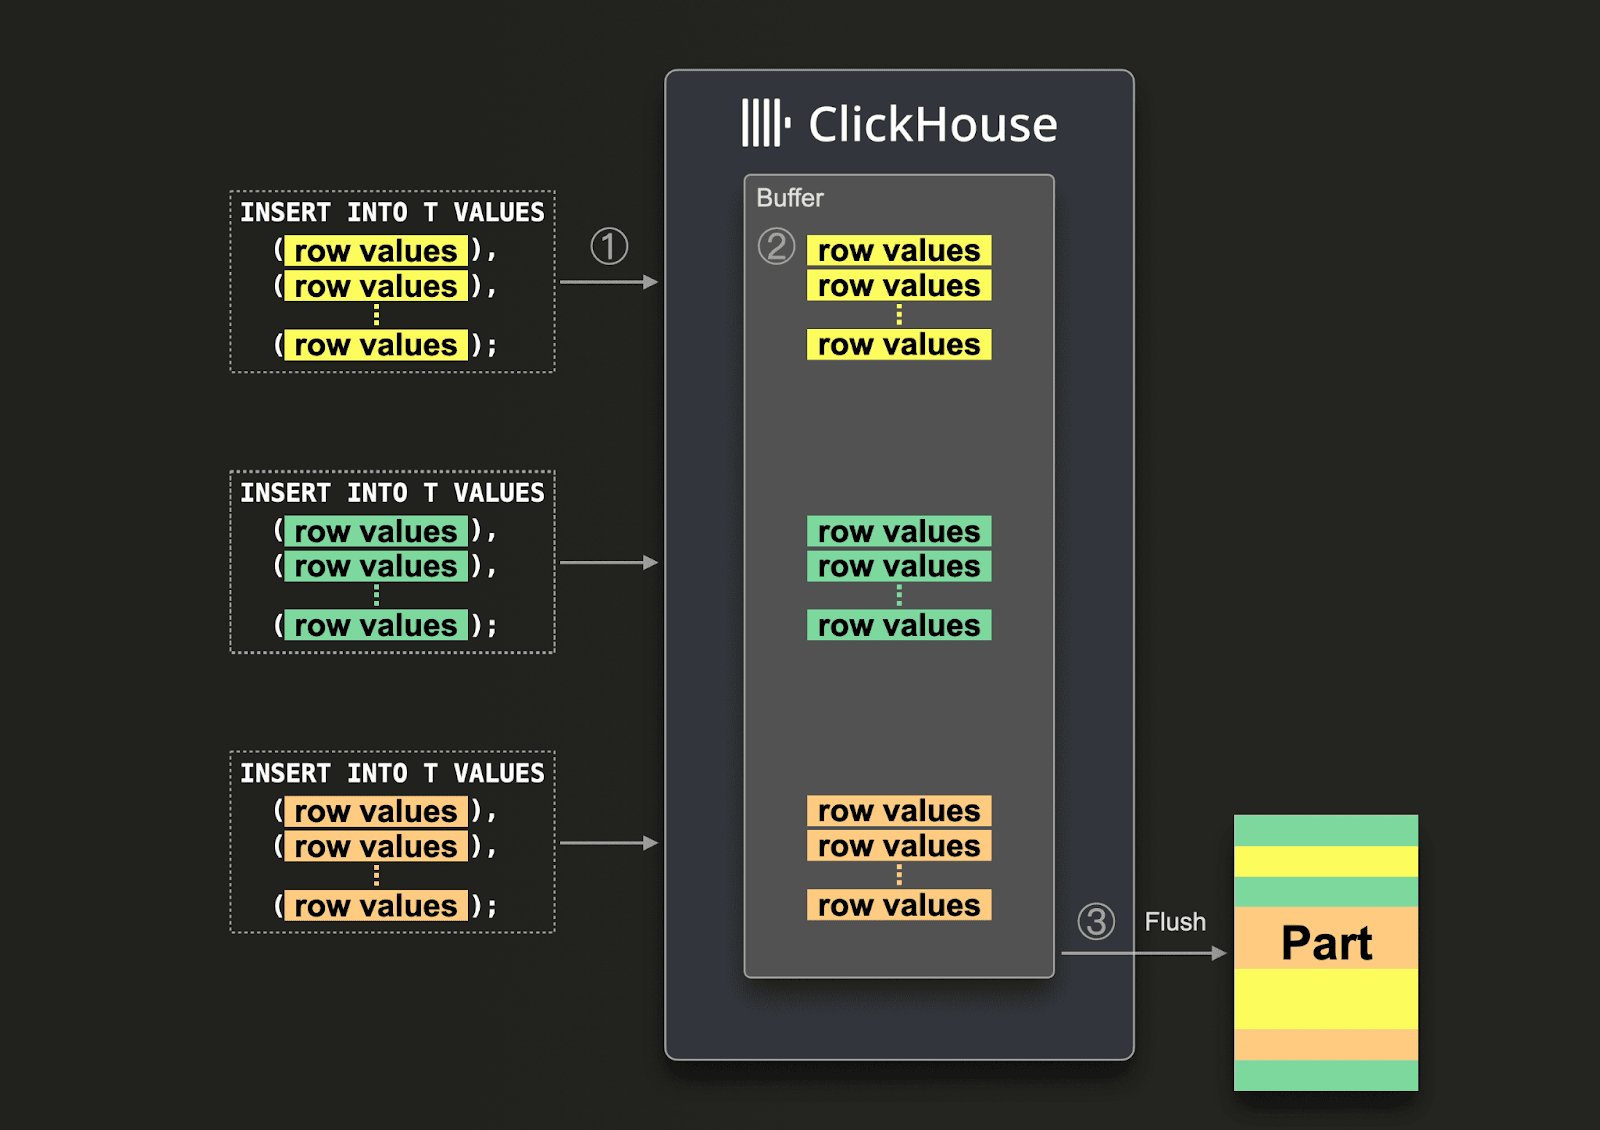
Если вставлять большие батчи не получается, можно делегировать батчинг ClickHouse с помощью асинхронных вставок.
При асинхронных вставках данные сначала попадают в буфер, а затем позже записываются в хранилище базы данных в 3 этапа, как показано на схеме ниже:
У ClickHouse есть клиенты для самых популярных языков программирования.
Они оптимизированы для корректного выполнения вставок и изначально поддерживают асинхронные вставки — либо напрямую, как, например, клиент Go, либо косвенно, если они включены в настройках на уровне запроса, пользователя или соединения.
Полный список доступных клиентов и драйверов ClickHouse см. в разделе Native Clients and Interfaces.
ClickHouse поддерживает множество форматов ввода при вставке данных (и выполнении запросов).
Это важное отличие от OLTP-баз данных, которое значительно упрощает загрузку данных из внешних источников — особенно в сочетании с табличными функциями и возможностью загружать данные из файлов на диске.
Эти форматы идеально подходят для разовой загрузки данных и задач дата-инжиниринга.
Если приложению нужна оптимальная производительность вставки, используйте формат Native.
Он поддерживается большинством клиентов (например, Go и Python) и позволяет свести нагрузку на сервер к минимуму, поскольку этот формат уже является столбцово-ориентированным.
В результате ответственность за преобразование данных в столбцово-ориентированный формат переносится на сторону клиента. Это важно для эффективного масштабирования вставок.
В качестве альтернативы можно использовать формат RowBinary (как в Java-клиенте), если предпочтителен построчный формат — его обычно проще формировать, чем формат Native.
С точки зрения сжатия, сетевых накладных расходов и обработки на сервере он эффективнее, чем другие построчные форматы, такие как JSON.
Формат JSONEachRow можно рассмотреть, если у вас невысокая пропускная способность записи и нужно быстро выполнить интеграцию. Однако учитывайте, что из-за парсинга этот формат создает дополнительную нагрузку на CPU в ClickHouse.
В отличие от многих традиционных баз данных, ClickHouse поддерживает HTTP-интерфейс.
Его можно использовать как для вставки данных, так и для выполнения запросов, применяя любой из перечисленных выше форматов.
Часто это предпочтительнее собственного протокола ClickHouse, поскольку трафик в этом случае легко направлять через балансировщики нагрузки.
При использовании собственного протокола возможны небольшие отличия в производительности вставки, так как у него немного меньше накладных расходов.
Существующие клиенты используют либо один из этих протоколов, либо оба сразу (например, клиент Go).
Собственный протокол также позволяет легко отслеживать прогресс выполнения запроса.
См. HTTP-интерфейс, чтобы узнать подробности.
Вы можете использовать в ClickHouse привычную команду
INSERT INTO TABLE. Давайте вставим данные в таблицу, которую мы создали в руководстве быстрого старта “Создание таблиц в ClickHouse”.
SELECT:
ClickPipes— ETL-инструмент, специально разработанный для репликации баз данных PostgreSQL. Он доступен в обоих вариантах:- ClickHouse Cloud — через наш управляемый сервис ингестии в ClickPipes.
- Самоуправляемый — через open-source-проект PeerDB.
- PostgreSQL table engine для прямого чтения данных, как показано в предыдущих примерах. Обычно это подходящий вариант, если достаточно батч-репликации на основе известной водяной метки, например временной метки, или если речь идёт о разовой миграции. Этот подход масштабируется до десятков миллионов строк. Если вам нужно мигрировать более крупные наборы данных, стоит разбить процесс на несколько запросов, каждый из которых обрабатывает фрагмент данных. Для каждого фрагмента можно использовать staging-таблицы до переноса его партиций в итоговую таблицу. Это позволяет повторно выполнять запросы, завершившиеся ошибкой. Дополнительные сведения об этой стратегии массовой загрузки см. здесь.
- Данные можно экспортировать из PostgreSQL в формате CSV. Затем их можно вставить в ClickHouse либо из локальных файлов, либо через Объектное хранилище с использованием табличных функций.
Нужна помощь со вставкой больших наборов данных?Если вам нужна помощь со вставкой больших наборов данных или вы столкнулись с ошибками при импорте данных в ClickHouse Cloud, свяжитесь с нами по адресу support@clickhouse.com, и мы поможем.
- У вас установлен ClickHouse
clickhouse-serverзапущен- У вас есть доступ к терминалу, где доступны
wget,zcatиcurl
1
Скачайте CSV
Выполните следующую команду, чтобы скачать CSV-версию набора данных из нашего публичного S3 бакета:Этот сжатый файл размером 4,6 ГБ, содержащий 28 млн строк, должен скачаться за 5–10 минут.
2
Создайте таблицу
При запущенном Если ошибок нет, таблица успешно создана. В команде выше вокруг разделителя heredoc (
clickhouse-server вы можете создать пустую таблицу со следующей схемой прямо из командной строки с помощью clickhouse-client в батч-режиме:_EOF) используются одинарные кавычки, чтобы предотвратить подстановку значений. Без одинарных кавычек пришлось бы экранировать обратные кавычки вокруг имен столбцов.3
Вставьте данные из командной строки
Теперь выполните приведенную ниже команду, чтобы вставить в таблицу данные из файла, который вы скачали ранее:Поскольку данные сжаты, сначала нужно распаковать файл с помощью Когда вставка завершится, вы можете выполнить следующую команду, чтобы посмотреть количество строк в таблице
gzip, zcat или аналогичного инструмента, а затем передать распакованные данные по каналу в clickhouse-client с соответствующим оператором INSERT и FORMAT.При вставке данных с помощью clickhouse-client в интерактивном режиме можно позволить ClickHouse выполнить распаковку за вас во время вставки с помощью предложения
COMPRESSION. ClickHouse может автоматически определить тип сжатия по расширению файла, но его также можно указать явно.Тогда запрос на вставку будет выглядеть так:hackernews:4
Вставка данных через командную строку с использованием curl
В предыдущих шагах вы сначала скачали CSV-файл на локальную машину с помощью Теперь выполните:Теперь вы можете выполнить ту же команду, что и ранее, чтобы убедиться, что данные были вставлены повторно:
wget. Также можно вставить данные напрямую с удаленного URL одной командой.Выполните следующую команду, чтобы удалить данные из таблицы hackernews и затем вставить их снова без промежуточного скачивания на локальную машину: