

JOIN. Алгоритмы выполнения и выбор алгоритма описаны в разделе Соединение таблиц.
Старайтесь избегать JOIN
ClickHouse поддерживает широкий спектр типов соединения и алгоритмов JOIN. Однако JOIN по своей природе затратнее, чем запросы к одной денормализованной таблице. Денормализация переносит вычислительную нагрузку с этапа выполнения запроса на этап вставки или предварительной обработки, что часто существенно снижает задержку во время выполнения. Для аналитических запросов в реальном времени или запросов, чувствительных к задержке, денормализация настоятельно рекомендуется. В общем случае денормализация оправдана, если:- Таблицы изменяются редко или допустимо пакетное обновление.
- Связи не являются многие-ко-многим и не имеют чрезмерно высокой мощности.
- В запросах будет использоваться только ограниченное подмножество столбцов, то есть некоторые столбцы можно исключить из денормализации.
- У вас есть возможность перенести обработку из ClickHouse во внешние системы, такие как Flink, где можно выполнять обогащение или уплощение в реальном времени.
Когда без JOIN не обойтись
Чтобы повысить производительность JOIN, следуйте этим рекомендациям:- Используйте
ANYJOIN, когда достаточно одного совпадения. Обычный JOIN возвращает все совпадающие строки и при дублирующихся ключах может дать декартово произведение. Если достаточно одного совпадения, используйтеLEFT ANY JOINилиANY INNER JOIN: это уменьшит размер результата и потребление памяти. - Сокращайте обе стороны до выполнения JOIN. Применяйте селективные условия в предложениях
WHEREиJOIN ON. ClickHouse по возможности проталкивает фильтры вниз, но явные подзапросы гарантируют, что каждая из входных сторон будет отфильтрована до JOIN. - Рассмотрите
INвместоINNER JOIN. Если запросу нужно лишь проверить, есть ли ключ в другой таблице, подзапросINвыражает это требование напрямую и может потреблять меньше памяти, чем формирование результатаINNER JOIN. - Для многократно используемого поиска выбирайте движок таблицы
Join. Движок таблицыJoinхранит заранее вычисленную структуру в памяти для заданных типа соединения, строгости и ключа. В ClickHouse Cloud он реализован какSharedJoinс базовой таблицейMergeTree, аJoin(ANY, LEFT, key)обеспечивает обновляемый поиск по ключу. См. Fast, updatable lookups with the Join table engine. - По возможности выполняйте JOIN по ключам сортировки таблиц. Если обе таблицы физически упорядочены по ключу JOIN,
full_sorting_mergeможет пропустить сортировку и снизить потребление памяти. Проверьте план выполнения и сравните этот алгоритм с алгоритмом по умолчанию на репрезентативных данных. - Избегайте JOIN со сбросом данных на диск. Сброс промежуточного состояния JOIN на диск позволяет запросу уложиться в ограничение памяти, но дисковый ввод-вывод обычно увеличивает задержку. Хеш-соединения при достижении настроенных порогов сброса на диск могут переключаться на grace hash, а соединения слиянием — использовать внешнюю сортировку. Прежде чем полагаться на сброс данных на диск, сократите количество входных строк и столбцов или измените модель данных. Подробнее см. в разделе Выбор оптимального алгоритма JOIN.
- При необходимости используйте значения по умолчанию как маркеры отсутствия совпадения. Значение по умолчанию
join_use_nulls = 0заполняет несопоставленные столбцы внешнего JOIN значением по умолчанию для их типа данных и позволяет обойтись без обёртокNullable. Включайтеjoin_use_nulls, только если запросу нужно отличать несопоставленную строку от сопоставленной строки, содержащей значение по умолчанию.
Выбор оптимального алгоритма JOIN
ClickHouse поддерживает несколько алгоритмов JOIN, каждый из которых по-своему балансирует между скоростью и потреблением памяти. Значениеjoin_algorithm по умолчанию — direct,parallel_hash,hash,ie_join: ClickHouse выбирает первый алгоритм, применимый с учётом типа соединения, строгости, условия и движка таблицы. Менять эту настройку имеет смысл только после того, как оба входных набора данных уже сокращены, и лишь если измерения на репрезентативных данных показывают, что нужна другая стратегия использования памяти или выполнения. Подробнее о выполнении алгоритмов и поддерживаемых типах соединения см. в разделе Выбор алгоритма JOIN.
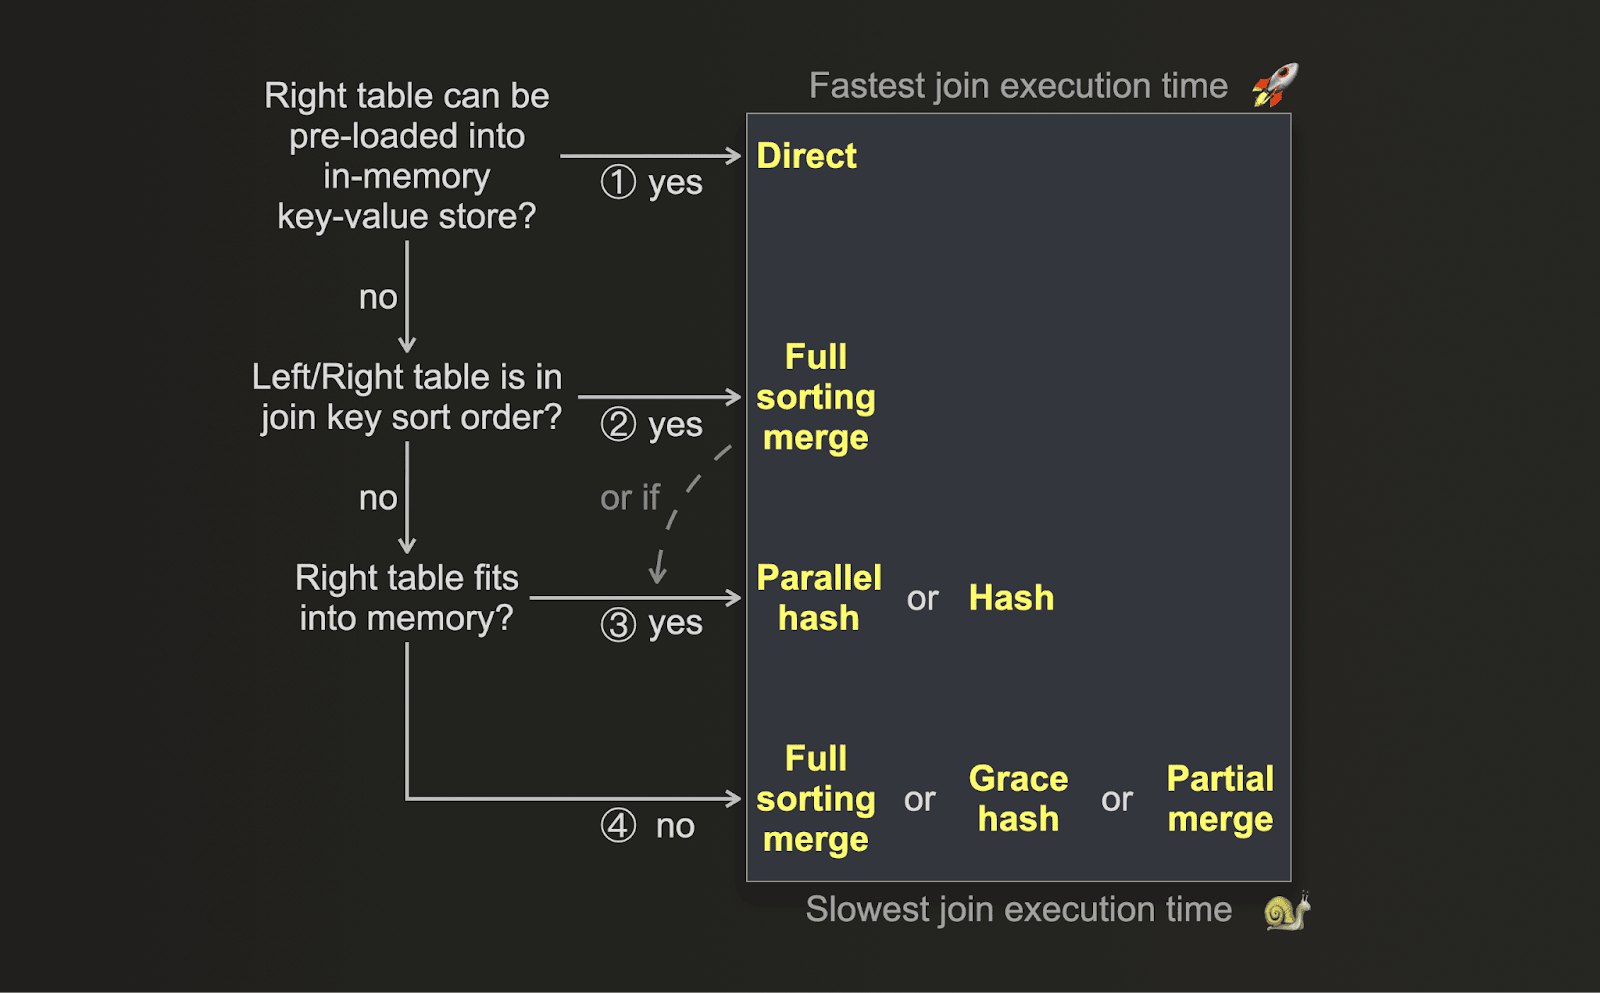
Если ваша главная метрика оптимизации — производительность и нужно выполнить JOIN как можно быстрее, выбрать подходящий алгоритм соединения поможет следующее дерево решений:
-
(1) Если данные правой таблицы можно заранее загрузить в находящуюся в памяти структуру данных ключ-значение с низкой задержкой (например, в словарь), ключ JOIN совпадает с ключевым атрибутом этого хранилища ключ-значение, а семантики
LEFT ANY JOINдостаточно, то можно использовать direct join — зачастую это самый быстрый вариант. - (2) Если физический порядок строк в таблице совпадает с порядком сортировки по ключу JOIN, всё зависит от конкретного случая. Здесь полное сортирующее соединение слиянием пропускает фазу сортировки, что значительно снижает использование памяти, а в зависимости от объёма данных и распределения значений ключа JOIN может работать и быстрее некоторых алгоритмов хеш-соединения.
- (3) Если правая таблица помещается в память даже с учётом дополнительных накладных расходов на память у параллельного hash JOIN, то этот алгоритм или хеш-соединение могут оказаться быстрее. Это зависит от объёма данных, типов данных и распределения значений в столбцах ключа JOIN.
-
(4) Если правая таблица не помещается в память, хеш-соединение и параллельный hash JOIN могут сбрасывать данные на диск, переключаясь на хеш-соединение Grace при достижении порога
max_bytes_before_external_joinилиmax_bytes_ratio_before_external_join. Полное сортирующее соединение слиянием и частичное соединение слиянием также умеют использовать внешнее хранилище. Какой подход окажется самым быстрым, зависит от объёма данных, типов данных и распределения значений в столбцах ключа JOIN.
grace_hash_join_initial_buckets задаёт начальное количество корзин и позволяет подобрать баланс между использованием памяти и скоростью соединения.
Какой из трёх дисковых алгоритмов окажется самым быстрым, зависит от объёма данных, типов данных и распределения значений в столбцах ключа JOIN. Чтобы это выяснить, лучше всего провести бенчмарки на реалистичных объёмах ваших данных.
Оптимизация по памяти
Если вы хотите оптимизировать JOIN не по минимальному времени выполнения, а по минимальному использованию памяти, воспользуйтесь следующим деревом решений: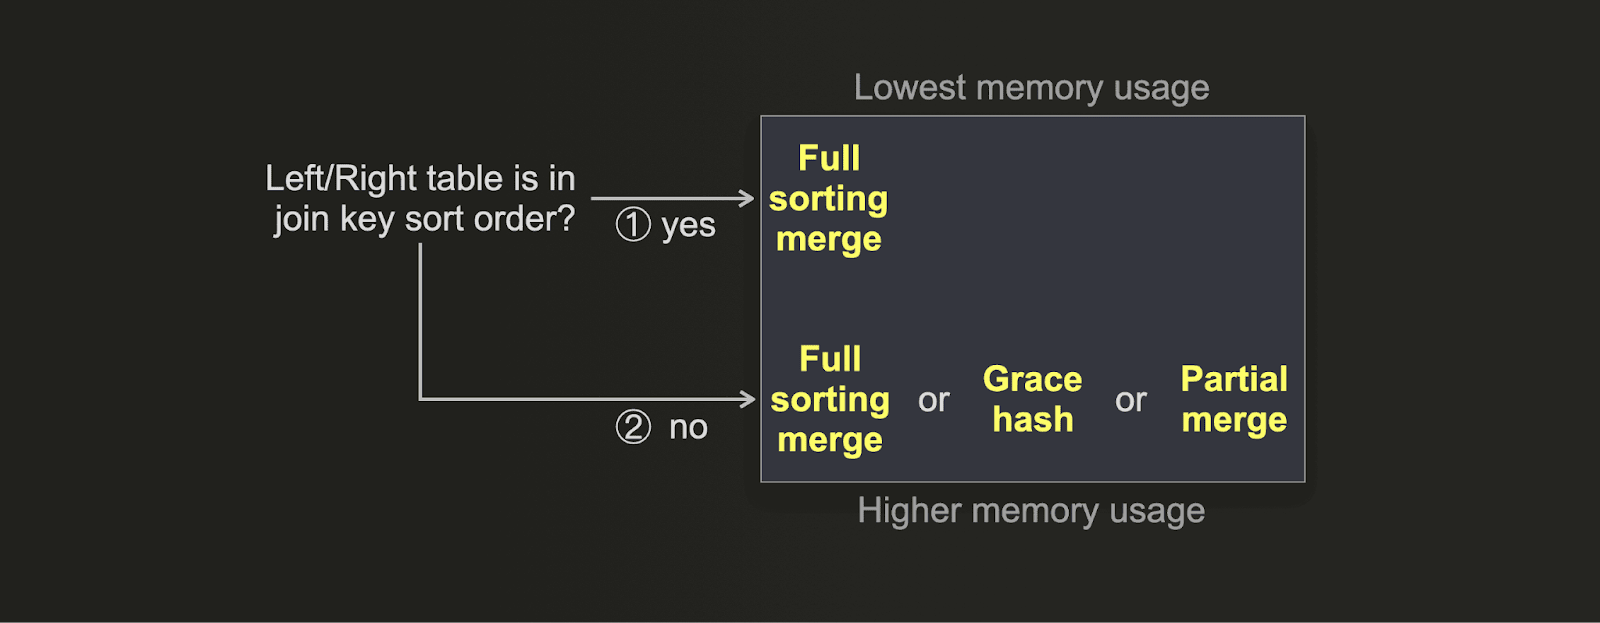
- (1) Если физический порядок строк в таблице совпадает с порядком сортировки по ключу JOIN, полное сортирующее соединение слиянием использует минимально возможный объём памяти и при этом обеспечивает высокую скорость JOIN, поскольку этап сортировки пропускается.
- (2) Хеш-соединение Grace можно настроить на очень низкое использование памяти, увеличив значение
grace_hash_join_initial_buckets, но ценой снижения скорости JOIN. Частичное соединение слиянием намеренно расходует мало оперативной памяти. Полное сортирующее соединение слиянием с включённой внешней сортировкой, как правило, потребляет больше памяти, чем частичное соединение слиянием, если порядок строк не совпадает с порядком сортировки по ключу, зато JOIN выполняется значительно быстрее. Хеш-соединение и параллельный hash JOIN также позволяют снизить нехватку памяти: при достижении настроенного порога сброса на диск они переключаются на хеш-соединение Grace.
Примеры оптимизации JOIN
В следующих примерах используется набор данных Stack Overflow, а рекомендации применяются поэтапно. Приведённые ниже результаты — медианные значения по пяти запускам на сервисе ClickHouse Cloud с ClickHouse 26.8.1 иmax_threads = 4. Каждый запрос предварительно прогревался один раз, порядок выполнения запросов чередовался, а use_query_cache и use_query_condition_cache были отключены.
Замена ANY INNER JOIN на IN
В этом тесте запрос с IN выполнился в 2,7 раза быстрее, а пиковое потребление памяти снизилось на 83%.
Этот запрос подсчитывает посты, в которых не упоминается ClickHouse, но есть хотя бы один комментарий с таким упоминанием:
86. Медианное затраченное время выполнения составило 27,101 секунды, пиковое потребление памяти — 970,01 МиБ. Запрос прочитал 150,20 миллиона строк и 51,77 ГиБ данных.
Запросу достаточно лишь установить наличие подходящего комментария. Подзапрос с IN позволяет обойтись без формирования результата JOIN:
IN также возвращает 86. Медианное затраченное время составило 10,206 секунды, пиковое потребление памяти — 162,81 МиБ. Было прочитано 174,20 миллиона строк и 19,02 ГиБ данных.
Фильтрация обеих сторон перед заменой JOIN
В этом тесте переписывание сократило медианное затраченное время на 18%, а пиковое потребление памяти — на 14%. Этот запрос подсчитывает голоса «за» для постов о Java, созданных начиная с 2020 года. Условие по дате применяется к обоим входным наборам данных ещё до выполнения JOIN:261915. Медианное затраченное время составило 0,850 секунды, пиковое потребление памяти — 59,96 МиБ. Было прочитано 80,94 миллиона строк и 1,13 ГиБ данных.
Для каждого голоса достаточно лишь наличия соответствующего поста, поэтому JOIN можно заменить на IN, сохранив фильтры на обеих входных сторонах:
IN также возвращает 261915. Медианное затраченное время его выполнения составило 0,696 секунды, пиковое потребление памяти — 51,70 МиБ. Было прочитано 46,20 миллиона строк и 817,49 МиБ данных.