

Вы можете записаться в список ожидания закрытой предварительной версии здесь.
APPENDS и CHANGES.
BigQuery ClickPipes можно вручную развёртывать и настраивать через интерфейс ClickPipes, а также программно с помощью OpenAPI и Terraform.
Первоначальная загрузка
При первоначальной загрузке выбранные таблицы из набора данных BigQuery копируются в ClickHouse. Её можно выполнить отдельно или затем перейти к непрерывной репликации. Для промежуточного хранения данных используется указанный вами бакет Google Cloud Storage (GCS). ClickPipe, настроенный только на первоначальную загрузку, останавливается после её завершения.ClickPipes использует запросы BigQuery
EXPORT DATA, чтобы скопировать данные в бакет промежуточного хранилища. BigQuery взимает плату за выполнение этих запросов; хранение данных в GCS также оплачивается.Непрерывная репликация
После первоначальной загрузки ClickPipe для BigQuery может периодически проверять наличие новых данных и переносить их в ClickHouse. Непрерывную репликацию можно запустить и без первоначальной загрузки. Выбирайте метод репликации в зависимости от того, как изменяется исходная таблица. В примерах показана структура запросов; ClickPipes выбирает настроенные столбцы и метаданные событий.
Для репликации на основе запросов выберите в каждой таблице столбец, который будет служить водяной меткой. Он должен иметь тип
TIMESTAMP и входить в число реплицируемых столбцов. Устанавливайте его значение при вставке или обновлении строки. Если строка изменится, но значение водяной метки не обновится, ClickPipes не обнаружит это изменение. Если необходимо реплицировать удаления, используйте CHANGES.
Оба метода на основе событий работают только с обычными таблицами BigQuery. Для APPENDS включать историю изменений не нужно. Чтобы использовать CHANGES, включите историю изменений для каждой исходной таблицы перед созданием ClickPipe:
CHANGES также требует, чтобы для целевой таблицы был задан первичный ключ BigQuery или пользовательский ключ сортировки. Выберите столбцы, по которым можно однозначно определить строку, чтобы ClickPipes применял обновления и удаления к нужной строке. BigQuery не проверяет соблюдение ограничений первичного ключа, поэтому значения этих столбцов в исходных данных должны быть уникальными.
APPENDS и CHANGES могут считывать изменения только в пределах окна путешествия во времени BigQuery для исходной таблицы. По умолчанию оно составляет семь дней, но может быть сокращено до двух. Если репликация отстанет настолько, что изменения выйдут за пределы этого окна, заново выполните первоначальную загрузку, чтобы восстановить полную копию. BigQuery взимает плату за запросы, выполняемые всеми тремя методами. Включение истории изменений для CHANGES также увеличивает затраты на хранение в BigQuery.Учетные данные сервисного аккаунта
ClickPipes аутентифицируется в вашем проекте Google Cloud с помощью ключа сервисного аккаунта. Мы рекомендуем создать отдельный сервисный аккаунт с минимально необходимым набором разрешений, чтобы ClickPipes мог экспортировать данные из BigQuery, загружать их в промежуточный GCS-бакет и считывать в ClickHouse.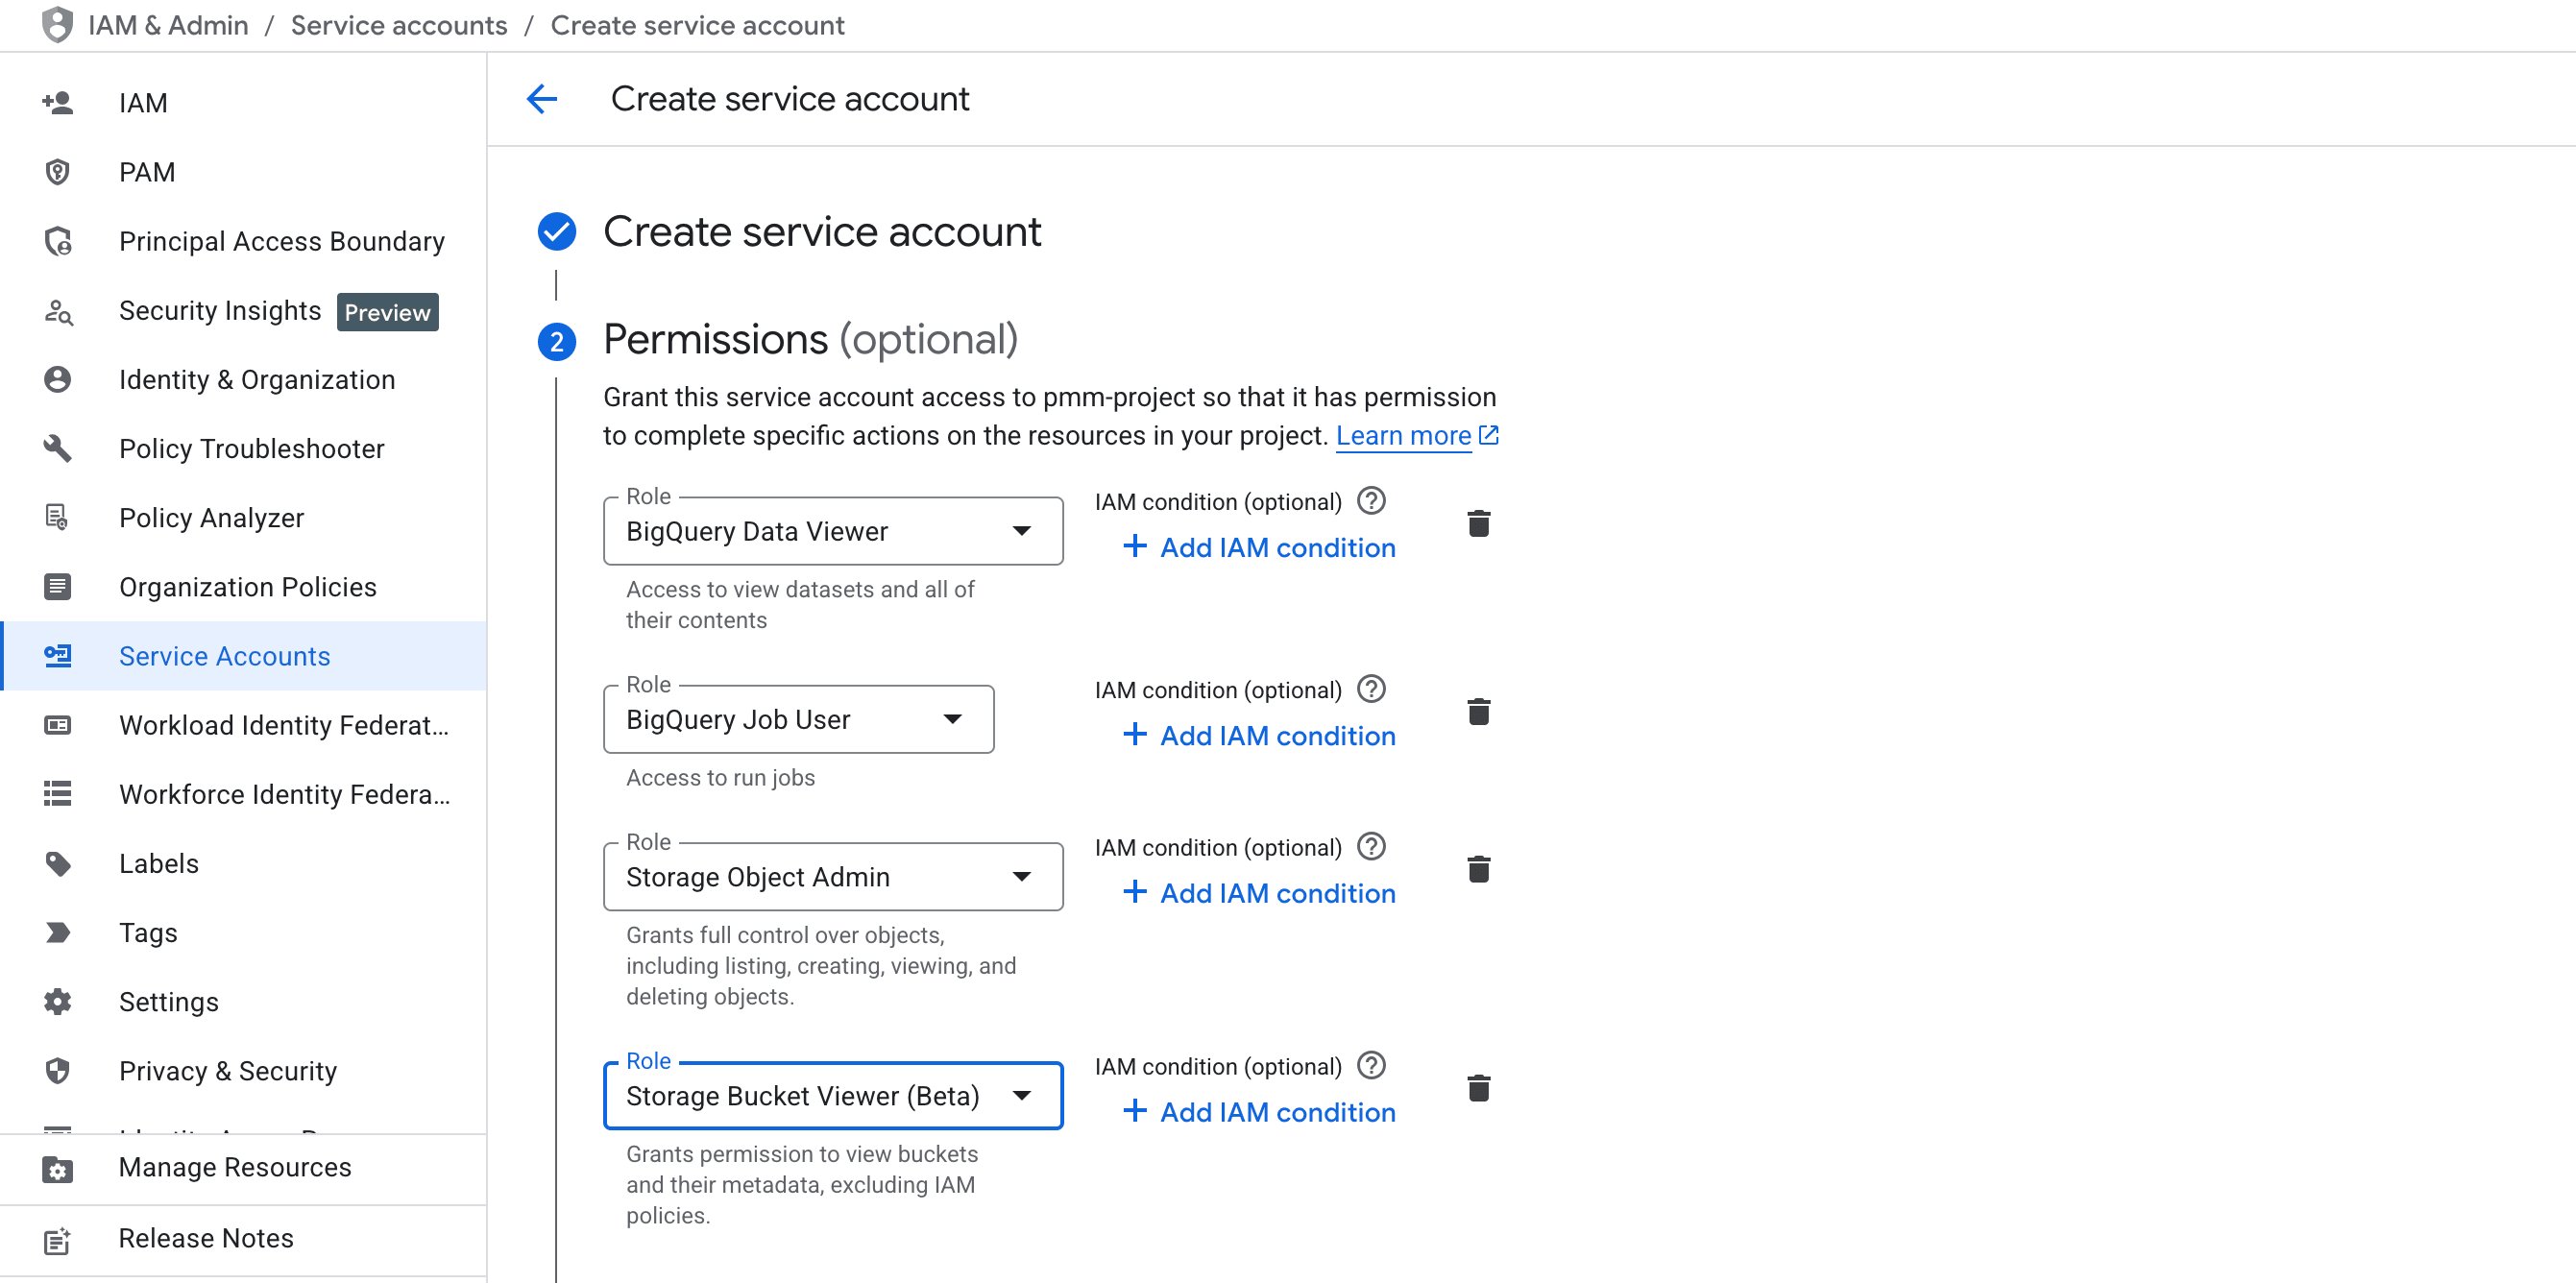
GCP Workload Identity (бета)
Следуя руководству по GCP Workload Identity, получите управляемую служебную учётную запись из контекста сервиса ClickPipes. Назначьте ей перечисленные ниже роли BigQuery и GCS и создайте пайп с методом аутентификацииSERVICE_ACCOUNT_WORKLOAD_IDENTITY. При использовании этого метода аутентификации не указывайте учётные данные служебной учётной записи.
BigQuery
Служебной учётной записи, которую использует ClickPipes (предоставленной вами или управляемой через workload identity), нужны следующие роли BigQuery: Для непрерывной репликации также выдайте рольroles/bigquery.readSessionUser на уровне проекта Google Cloud. ClickPipes использует BigQuery Storage Read API, чтобы создавать сеансы чтения и считывать результаты запросов CDC (фиксации изменений данных). Эту роль нельзя выдать на уровне набора данных, поэтому сохраните роль roles/bigquery.dataViewer для исходных наборов данных или таблиц, чтобы служебная учётная запись могла читать их данные.
Чтобы дополнительно сузить область доступа, рекомендуем использовать условия IAM, чтобы ограничить ресурсы, к которым у роли есть доступ. Например, роль dataViewer можно ограничить конкретным набором данных, содержащим таблицы, которые вы хотите синхронизировать:
objectAdmin и bucketViewer, предоставив им доступ только к выделенному бакету, созданному для синхронизации ClickPipes.