

Лексикографический порядок
GCS ClickPipe предполагает, что файлы добавляются в бакет в лексикографическом порядке, и опирается на этот неявный порядок для последовательного приёма файлов. Это означает, что любой новый файл должен быть лексикографически больше последнего принятого файла. Например, файлы с именамиfile1, file2 и file3 будут приниматься последовательно, но если в бакет будет добавлен новый file 0, он будет проигнорирован, поскольку имя этого файла не лексикографически больше имени последнего принятого файла.
В этом режиме GCS ClickPipe выполняет начальную загрузку всех файлов по указанному пути, а затем с настраиваемым интервалом проверяет наличие новых файлов (по умолчанию — каждые 30 секунд). Чтобы начать непрерывную ингестию после определённого файла, настройте Start after. ClickPipes пропустит файлы, которые лексикографически меньше или равны настроенному значению, и продолжит приём более новых файлов с этого момента.
В любом порядке
Можно настроить GCS ClickPipe на приём файлов, у которых нет естественного порядка, создав подписку Google Cloud Pub/Sub, получающую уведомления от бакета. Это позволяет ClickPipes отслеживать события создания объектов и принимать любые новые файлы независимо от схемы их именования.Неупорядоченный режим не поддерживается для публичных бакетов. Для него требуется аутентификация через служебную учётную запись (с помощью загруженного ключа или GCP Workload Identity) и подписка Google Cloud Pub/Sub, подключённая к бакету.
OBJECT_FINALIZE через подписку Pub/Sub, соответствующие указанному пути. Любые сообщения о ранее обнаруженном файле, файле, не соответствующем пути, или событии другого типа будут игнорироваться. Чтобы принимать только файлы, доставленные через подписку, включите Пропустить первоначальную загрузку. При включении этой опции ClickPipes пропускает начальное сканирование существующих файлов по выбранному пути и обрабатывает только файлы, доставленные через подписку Pub/Sub.
ClickPipes для объектного хранилища используют стандарт POSIX для сопоставления имён файлов по шаблону. Все шаблоны чувствительны к регистру и применяются к полному пути после имени бакета. Для лучшей производительности используйте максимально конкретный шаблон (например, data-2024-*.csv вместо *.csv).
Примеры:
https://bucket.s3.amazonaws.com/folder/*.csvhttps://bucket.s3.amazonaws.com/logs/**/data.jsonhttps://bucket.s3.amazonaws.com/file-?.parquethttps://bucket.s3.amazonaws.com/data-2024-*.csv.gz
Примеры:
https://bucket.s3.amazonaws.com/{documents-01,documents-02}.jsonhttps://bucket.s3.amazonaws.com/file-{1..100}.csvhttps://bucket.s3.amazonaws.com/{logs,metrics}/data.parquet
TRUNCATE, а затем повторить вставку с чистого состояния. Только после того, как вставка успешно завершена, партиции из staging-таблицы перемещаются в целевую таблицу. Подробнее об этой стратегии читайте в этой статье блога.
Чтобы отслеживать, какие файлы были обработаны, включите виртуальный столбец _file в список сопоставления столбцов. Виртуальный столбец _file содержит имя файла исходного объекта, которое можно использовать в запросах, чтобы определить, какие файлы уже были обработаны.
ClickPipe для GCS поддерживает публичные и приватные бакеты. Бакеты Requester Pays не поддерживаются.
Сервисный аккаунт, используемый ClickPipes, должен иметь следующие разрешения на уровне бакета:
Эта роль включает IAM-разрешения storage.objects.list и `storage.objects.get, которые позволяют ClickPipes просматривать список объектов и получать объекты в указанном бакете.
При использовании неупорядоченного режима сервисный аккаунт должен иметь следующие роли в подписке Pub/Sub:
roles/pubsub.subscriber— для получения сообщений и подтверждения их обработки.roles/pubsub.viewer— для просмотра метаданных подписки.
Идентификация рабочих нагрузок GCP (бета)
Следуйте руководству по идентификации рабочих нагрузок GCP, чтобы получить управляемую служебную учётную запись из контекста сервиса ClickPipes. Назначьте ей рольroles/storage.objectViewer для исходного бакета и создайте пайп с типом аутентификации SERVICE_ACCOUNT_WORKLOAD_IDENTITY. Для неупорядоченной ингестии дополнительно назначьте ей роли roles/pubsub.subscriber и roles/pubsub.viewer для существующей подписки на уведомления и укажите полное имя этой подписки: projects/<project-id>/subscriptions/<subscription-id>.
Учетные данные HMAC
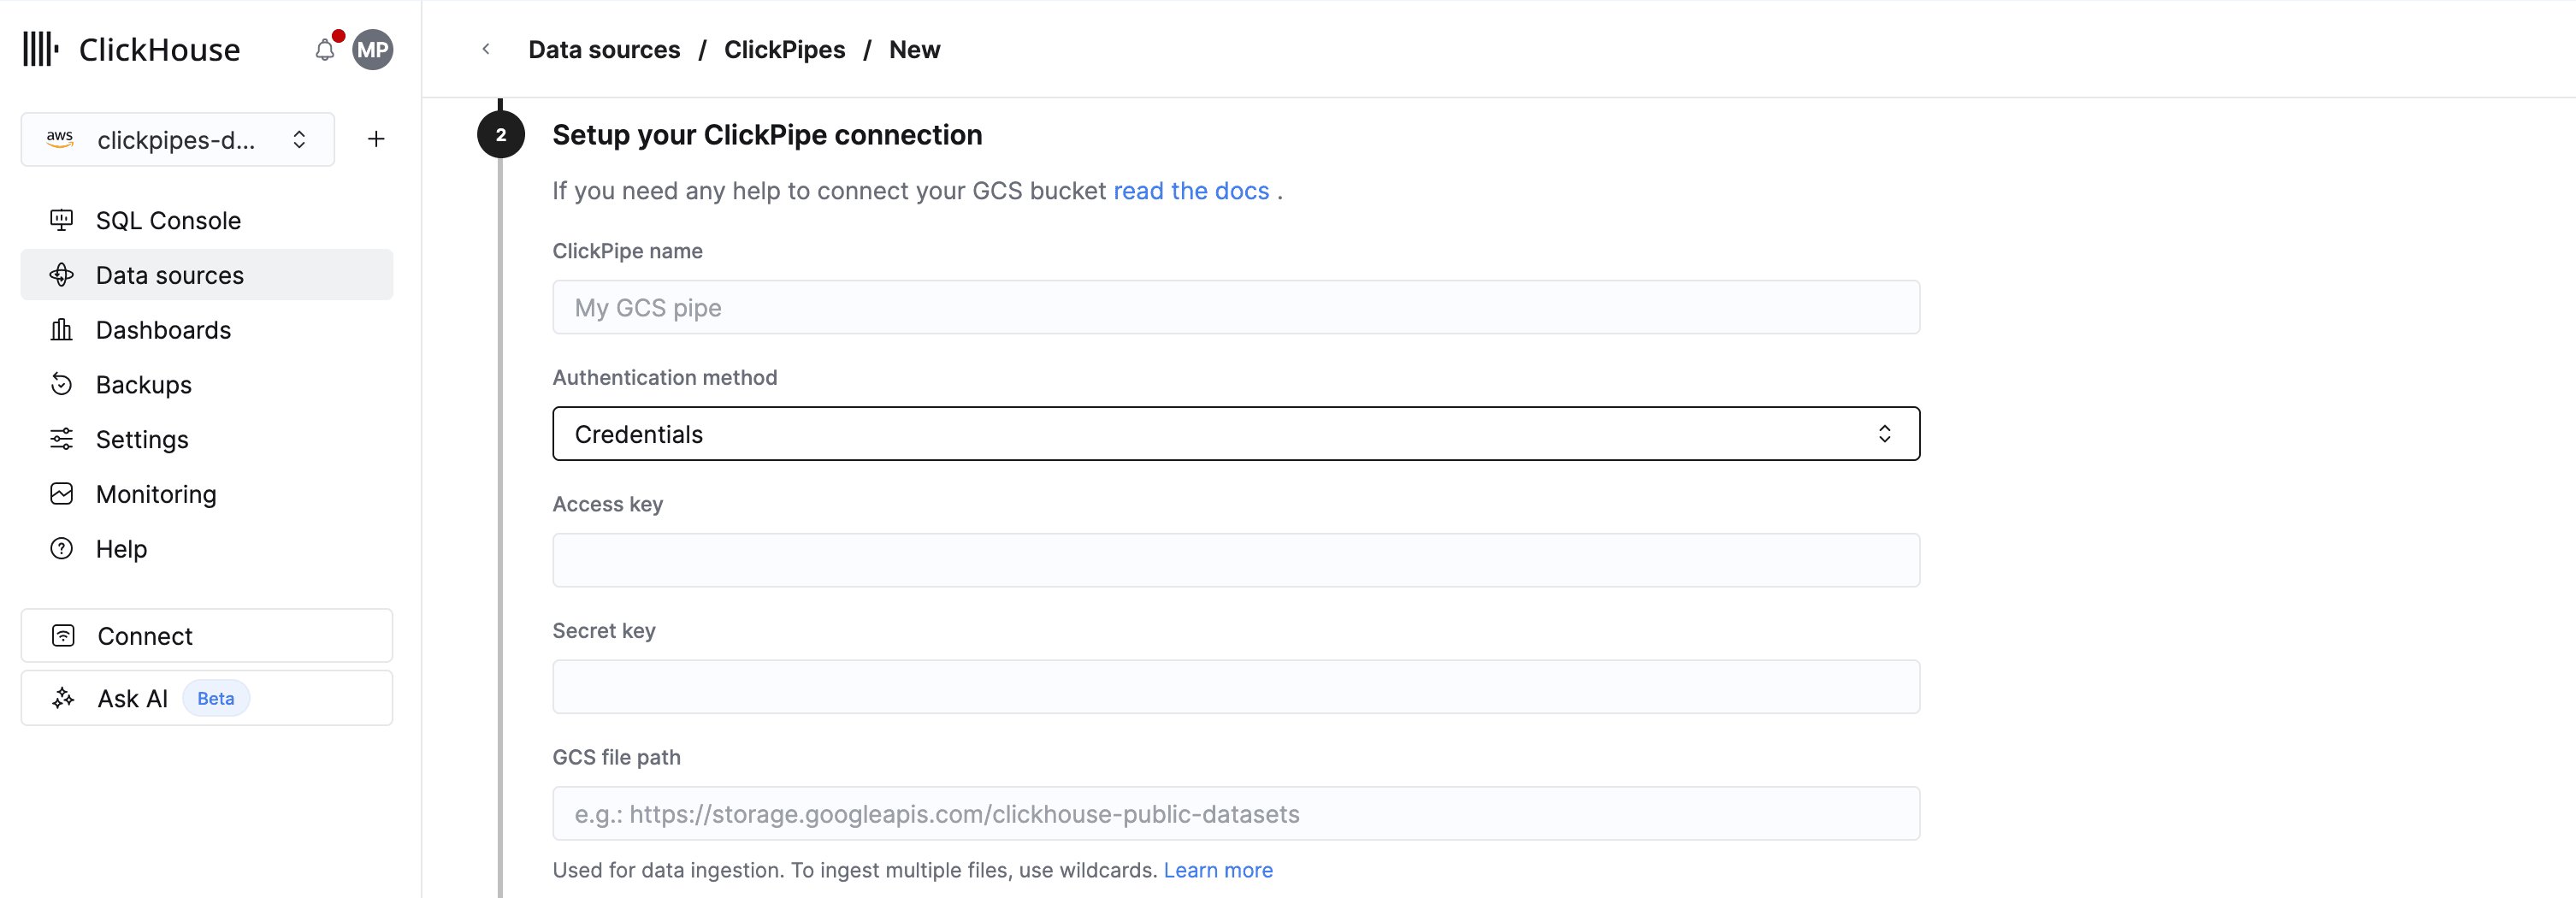
Чтобы использовать HMAC-ключи для аутентификации, при настройке подключения ClickPipe выберитеCredentials в разделе метод аутентификации. Затем укажите ключ доступа (например, GOOGTS7C7FUP3AIRVJTE2BCDKINBTES3HC2GY5CBFJDCQ2SYHV6A6XXVTJFSA) и секретный ключ (например, bGoa+V7g/yqDXvKRqq+JTFn4uQZbPiQJo4pf9RzJ) в полях Access key и Secret key соответственно.
Сетевой доступ
GCS ClickPipes используют два разных сетевых маршрута для обнаружения метаданных и ингестии данных: сервис ClickPipes и сервис ClickHouse Cloud соответственно. Если вы хотите настроить дополнительный уровень сетевой безопасности (например, в целях соответствия требованиям), сетевой доступ должен быть настроен для обоих маршрутов.-
Для управления доступом на основе IP правила IP-фильтрации для вашего бакета GCS должны разрешать статические IP-адреса региона сервиса ClickPipes, перечисленные здесь, а также статические IP-адреса сервиса ClickHouse Cloud. Чтобы получить статические IP-адреса для вашего региона ClickHouse Cloud, откройте терминал и выполните:
Расширенные настройки
ClickPipes предоставляет разумные значения по умолчанию, которые подходят для большинства сценариев использования. Если вашему сценарию требуется более тонкая настройка, вы можете изменить следующие параметры: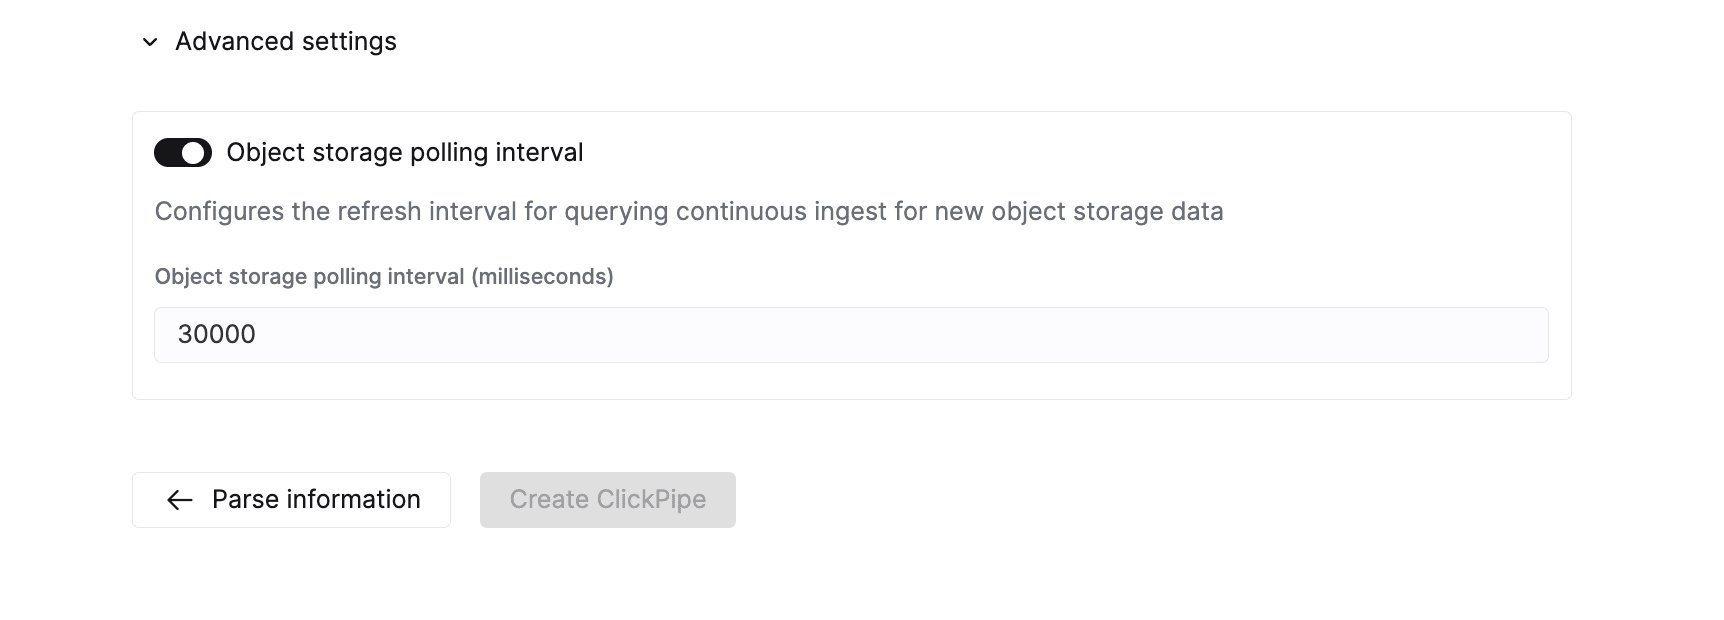
https://storage.googleapis.com/ (вместо gs://) и HMAC-ключи для аутентификации.
Также поддерживаются materialized view для целевой таблицы. ClickPipes создаёт staging-таблицы не только для целевой таблицы, но и для всех зависящих от неё materialized view.
Мы не создаём staging-таблицы для нематериализованных представлений. Это означает, что если у вас есть целевая таблица с одной или несколькими downstream materialized view, этим materialized view не следует выбирать данные через представление поверх целевой таблицы. В противном случае часть данных может отсутствовать в materialized view.